
Redis简介
参考文献:
《Redis 开发与运维》
《Redis 设计与实现》
Redis-Zero-To-Master-In-30-Minutes
文章部分内容翻译自官网及其他文档,译的不好,还请见谅!
一、NoSQL
数据库大体可以分为两种形式
- 一种以 SQL 为代表的关系型数据库
- 一种以非 SQL 为代表的非关系型数据库
NoSQL 数据库千奇百怪,其最初的目的是解决大数据的问题,但还是有人直接用来替换关系型数据库
下面是一下常见的 NoSQL 数据库和它的一些参考文档
-
列式数据库 Colume Database
- Cassandra
- HBase
- in-depth-look-hbase-architecture 官网文档组织混乱,看这篇就够了
-
文档数据库 Document Database
- MongoDB
- SimpleDB
- CouchDB
-
数据结构数据库 Data structure Database - Redis
-
图数据库 - Graph platform
-
搜索数据库 - ElasticSearch
ElasticSearch 学习基本上看官网文档就够了 ElasticSearch 官方文档
接下来是几篇性能调优相关的文章;
- Elasticsearch Performance Tuning Practice at eBay
- 9 tips on ElasticSearch configuration for high performance
最后是 GitHub 上的资源列表
二、Redis
Redis 的查询效率非常高,根据官方网站提供的数据,Redis 每秒最多处理的请求高达 10 万次.
Redis 全称是 REmote DIctionary Server,从名字就可以看出它是用字典结构存储数据的,也就是按照 key-value 这种格式存储数据
Redis 采用 ANSI C 语言编写。采用 C 语言编写的好处是底层代码执行效率高,依赖性低,系统兼容性好,稳定性高。
此外 Redis 还是基于内存的数据库,这样可以避免磁盘 I/O,因此 Redis 也经常被用作缓存工具。
除了上面介绍的,Redis 快的原因还不止这些。在 Redis6.0 之前,它采用的是单进程单线程模型,这样就避免了上下文切换和线程之间的资源竞争。
在技术上 Redis 还采用了多路 I/O 复用的技术,这里的多路指的是 Socket 网络连接,复用指的是复用同一个线程。这样做的好处是可以在同一个线程中处理多个 I/O 请求,尽量减少了网络 I/O 的消耗,提升执行效率。
关于 Redis 作为缓存服务器时和 Memcached 的对比,在 Stackoverflow 上有一篇回答可以看一下
2.1 环境安装
# Step 1: 下载软件包
shell> wget http://download.redis.io/releases/redis-4.0.14.tar.gz
# Step 2: 解压安装
shell> tar zxfv redis-4.0.14.tar.gz -C /usr/local/
shell> cd /usr/local/redis-4.0.14
shell> make
#符号链接
shell> for i in `ls -l /usr/local/redis-4.0.14/src/  | awk  '{print $NF}' | grep -v '\.' | grep '^r'`;do ln -s /usr/local/redis-4.0.14/src/$i /usr/local/bin/;done
# 启动服务

shell> redis-server /usr/local/redis-4.0.14/redis-conf
Redis 支持的数据类型包括:字符串、哈希、列表、集合、有序集合等
| 数据类型 | 说明 |
|---|---|
| String | 字符串 |
| List | 按照插入顺序存储的 String 集合 |
| Sets | 存储 String 类型的元素,它的元素无序且唯一 |
| Sorted Sets | 同 Sets,不过 Sorted Stes 是有序的 |
| Hashs | 由与值相关的字段组成的映射,都是 String 类型 |
2.2 String 数据类型
Redis 的 String 是binary safe的,并且最大可以存储 512MB
EXAMPLE:
shell> redis-cli
127.0.0.1:6379> SET name "xiacao"
127.0.0.1:6379> GET name
"xiacao"
上面的例子中,SET 和 GET 是 Redis 中的命令,name 是一个 key,xiacao 是存储在 Redis 里的一个字符串值
2.3 Hashs 数据类型
在 Redis 中,Hashs 类型表示:key-value 对的集合
它的结构表现为: key-field-value
EXAMPLE:
127.0.0.1:6379> HMSET user:1 username "wanghao" password "123" score "100"
127.0.0.1:6379> HGETALL user:1
1) "username"
2) "wanghao"
3) "password"
4) "123"
5) "score"
6) "100"
127.0.0.1:6379> HGET user:1 username
在上面的例子中,hash 数据类型被用来存储 user 这个结构对象,其中 user:1 作为整个 key,username/password/score 则为 field, 每个 field 后面的字符串都是 value
要设置和获取 Hashs 类型的数据,需要使用 HMSET 设置,使用 HGETALL 来获取所有数据。也可以使用 HGET 来获取某个 key 的某个 field
2.4 LIST 数据类型
Redis 的 LIST 中的元素都是字符串,而且它会按照字符串的插入顺序进行排序,并且元素的值可以重复。我们也可以指定在列表头部或尾部添加新元素
EXAMPLE:
127.0.0.1:6379> LPUSH database:columeType "HBase"
127.0.0.1:6379> LPUSH database:columeType "Hive" "ClickHouse" "Cassandra"
127.0.0.1:6379> LRANGE database:columeType 0 10
1) "Cassandra"
2) "ClickHouse"
3) "Hive"
4) "HBase"
127.0.0.1:6379> RPUSH database:columeType "sybase" "Hive"
127.0.0.1:6379> LRANGE database:columeType 0 10
1) "Cassandra"
2) "ClickHouse"
3) "Hive"
4) "HBase"
5) "sybase"
6) "Hive"
上面的例子中,LPUSH 表示往 database:columeType 列表左侧添加新元素
RPUSH 表示往 database:columeType 列表右侧添加新元素
如果要获取列表中的元素使用 LRANGE key start end 即可
start 和 end 表示索引,0 表示第一个元素
如果要删除 List 中的元素就使用LPOP key或者RPOP key
2.5 Set 数据类型
Redis 中的 Set 类型中的元素也都是 String 类型,它的特点是唯一且无序,也就是说 Set 内元素的值不能重复
EXAMPLE:
127.0.0.1:6379> SADD ops:zhengzhou:set "bobo" "kunkun" "wanghao"
(integer) 3
127.0.0.1:6379> SADD ops:zhengzhou:set "wanghao"
(integer) 0
127.0.0.1:6379> SMEMBERS ops:zhengzhou:set
1) "kunkun"
2) "bobo"
3) "wanghao"
127.0.0.1:6379> SISMEMBER ops:zhengzhou:set "jiaming"
(integer) 0
127.0.0.1:6379> SISMEMBER ops:zhengzhou:set "wanghao"
(integer) 1
127.0.0.1:6379> SREM ops:zhengzhou:set "wanghao"
(integer) 1
127.0.0.1:6379> SMEMBERS ops:zhengzhou:set
1) "kunkun"
2) "bobo"
上面的例子中:
SADD <key> [members ...]表示往 key 中添加新元素
SMEMBERS <key>表示查看给定 key 中的所有元素的值
SISMEMBER <key> [member] 表示查看给定的 member 是不是 set 中的一员
SREM <key> [member] 表示从 key 中删除给定的成员
2.6 Sorted Set 数据类型
Redis 中的 Sorted Set 和 Set 非常相似,成员都是字符串类型且不能重复.
Sorted Set 在 Set 的基础上添加了一个 Score 属性,这个属性在添加和修改元素的时候去指定,每次指定后,Sorted Set 都会按照 Score 属性来进行自动排序。
虽然成员是唯一的,但分数可能会重复,如果同一个元素,分数更高的将会替代分数低的元素
EXAMPLE:
127.0.0.1:6379> ZADD doc:Database 1 redis
127.0.0.1:6379> ZADD doc:Database 2 ElasticSearch
127.0.0.1:6379> ZADD doc:Database 3 mysql
(integer) 1
127.0.0.1:6379> ZADD doc:Database 3 mysql
(integer) 0
127.0.0.1:6379> ZADD doc:Database 4 mysql
(integer) 0
127.0.0.1:6379> ZRANGE doc:Database 0 10 WITHSCORES
1) "redis"
2) "1"
3) "ElasticSearch"
4) "2"
5) "mysql"
6) "4"
三、Redis Command
3.1 INFO MEMORY
127.0.0.1> INFO MEMORY
# Memory
used_memory:903423                   # Redis分配器分配的内存总量,单位byte
used_memory_human:882.25K            # 以更直观的单位展示分配的内存总量
used_memory_rss:2637824              # 向操作系统申请的内存大小
used_memory_rss_human:2.52M          # 以更直观的单位展示向操作系统申请的内存大小
used_memory_peak:903423              # redis的内存消耗峰值
used_memory_peak_human:882.25K       # 以更直观的格式返回redis的内存消耗峰值
used_memory_peak_perc:100.01%        # 使用内存达到峰值内存的百分比
used_memory_overhead:902720          # Redis为了维护数据集的内部机制所需的内存开销,包括所有客户端输出缓冲区、查询缓冲区、AOF重写缓冲区和主从复制的backlog
used_memory_startup:852738           # Redis服务器启动时消耗的内存
used_memory_dataset:703              # 数据实际占用的内存大小,即used_memory-used_memory_overhead
used_memory_dataset_perc:1.39%       # 数据占用的内存大小的百分比,100%*
total_system_memory:6087311360       # 系统内存总量
total_system_memory_human:5.67G      # 以更直观的格式展示系统内存总量
used_memory_lua:37888                # Lua脚本存储占用的内存
used_memory_lua_human:37.00K         # 以更直观的格式展示Lua脚本存储占用的内存
maxmemory:0                          # Redis实例的最大内存配置
maxmemory_human:0B                   # 以更直观的格式显示最大内存配置
maxmemory_policy:noeviction          # 当达到maxmemory时的淘汰策略
mem_fragmentation_ratio:2.92         # 碎片率
mem_allocator:libc                   # 内存分配器
active_defrag_running:0              # 表示没有活动的defrag任务正在运行,1表示有活动的defrag任务正在运行(defrag:表示内存碎片整理)
lazyfree_pending_objects:0           # 0表示不存在延迟释放的挂起对象
3.2 INFO STATS
127.0.0.1:6379> INFO STATS
total_connections_received:3         # 连接过的客户端的总数
total_commands_processed:54          # 执行过的命令总数
instantaneous_ops_per_sec:0          # 每秒处理的命令的条数
total_net_input_bytes:2946           # 输入总网络流量(单位:字节)
total_net_output_bytes:33582         # 输出总网络流量(单位:字节)
instantaneous_input_kbps:0.00        # 每秒输入字节数
instantaneous_output_kbps:0.00       # 每秒输出字节数
rejected_connections:0               # 拒绝连接的数量
sync_full:0                          # 主从完全同步成功次数
sync_partial_ok:0                    # 主从部分同步成功次数
sync_partial_err:0                   # 主从部分同步失败次数
expired_keys:0                       # 过期key的数量
expired_stale_perc:0.00              # 过期key占比
expired_time_cap_reached_count:0     # 过期计数
evicted_keys:0                       # 剔除的key(超过maxmemory后会剔除)
keyspace_hits:20                     # 命中次数
keyspace_misses:0                    # 不命中次数
pubsub_channels:0                    # 当前使用中的频道的数量
pubsub_patterns:0                    # 当前使用中的模式的数量
latest_fork_usec:129                 # 最后一次fork的耗时
migrate_cached_sockets:0             # 记录当前redis正在进行migrate操作的目标redis个数
slave_expires_tracked_keys:0         # 从实例到期key数量
active_defrag_hits:0                 # 主动碎片整理命中次数
active_defrag_misses:0               # 主动碎片整理未命中次数
active_defrag_key_hits:0             # 主动碎片整理key命中次数
active_defrag_key_misses:0           # 主动碎片整理key未命中次数
3.3 INFO COMMANDSTATS
127.0.0.1:6379> INFO COMMANDSTATS
# Commandstats
cmdstat_set:calls=2,usec=16,usec_per_call=8.00
cmdstat_smembers:calls=2,usec=37,usec_per_call=18.50
cmdstat_srem:calls=1,usec=4,usec_per_call=4.00
cmdstat_zrange:calls=2,usec=22,usec_per_call=11.00
cmdstat_hget:calls=1,usec=5,usec_per_call=5.00
cmdstat_zadd:calls=5,usec=85,usec_per_call=17.00
cmdstat_info:calls=7,usec=168,usec_per_call=24.00
cmdstat_hmset:calls=1,usec=18,usec_per_call=18.00
cmdstat_lpop:calls=1,usec=6,usec_per_call=6.00
cmdstat_command:calls=3,usec=1044,usec_per_call=348.00
cmdstat_lrange:calls=11,usec=73,usec_per_call=6.64
cmdstat_rpop:calls=1,usec=9,usec_per_call=9.00
cmdstat_hgetall:calls=1,usec=7,usec_per_call=7.00
cmdstat_get:calls=2,usec=8,usec_per_call=4.00
cmdstat_sismember:calls=2,usec=8,usec_per_call=4.00
cmdstat_sadd:calls=9,usec=85,usec_per_call=9.44
cmdstat_lpush:calls=3,usec=37,usec_per_call=12.33
cmdstat_rpush:calls=3,usec=18,usec_per_call=6.00
INFO COMMANDSTATS 显示了每种命令的调用执行次数(calls)、耗费 CPU 时间(usec),每个命令平均耗时(usec_per_call)
3.4 INFO PERSISTENCE
127.0.0.1:6379> INFO PERSISTENCE
# Persistence
loading:0                              # 正在加载dump file的数量
rdb_changes_since_last_save:0          # 最后一次dump后发生的改变次数
rdb_bgsave_in_progress:0               # RDB save 操作进行的数量
rdb_last_save_time:1594805092          # 最后一次成功RDB save后到现在的时间戳
rdb_last_bgsave_status:ok              # 最后一次RDB save操作状态
rdb_last_bgsave_time_sec:0             # 最后一次RDB save操作用时
rdb_current_bgsave_time_sec:-1         # 如果bgsave正在操作,则记录当前bgsave的时间
rdb_last_cow_size:327680               # 在执行bgsave期间,分配给COW的大小
aof_enabled:0                          # AOF 持久化是否开启,0未开启,1开启
aof_rewrite_in_progress:0              # AOF rewrite 进行的数量
aof_rewrite_scheduled:0                # 是否在RDB save操作完成后执行AOF重写标志
aof_last_rewrite_time_sec:-1           # 最后一次AOF rewrite 操作耗时
aof_current_rewrite_time_sec:-1        # 如果正在执行rewrite操作,则记录当前AOF rewrite所用的时间
aof_last_bgrewrite_status:ok           # 最后一次后台执行 AOF rewrite 操作状态
aof_last_write_status:ok               # 最后一次 AOF write 状态
aof_last_cow_size:0                    # 在执行AOF重写期间,分配给COW的大小。
3.5 INFO REPLICATION
127.0.0.1:6379> INFO REPLICATION
# Replication
role:master                                                # 当前实例的角色 master/slave
connected_slaves:0                                         # 连接到当前实例的slave数量
master_replid:d85f97ca25a7ee0fb234a61095e0577944dc6e91     # 识别增量的一个标识,自动生成,主要用于主从复制
master_replid2:0000000000000000000000000000000000000000    # 	未发生切换,即主实例未发生过变化,所以初始值为0
master_repl_offset:0                                       # 主节点的复制偏移量
second_repl_offset:-1                                      # 接受复制ID的偏移量
repl_backlog_active:0                                      # 开启复制缓冲区
repl_backlog_size:1048576                                  # 缓冲区最大长度

repl_backlog_first_byte_offset:0                           # 起始偏移量,计算当前缓冲区可用范围
repl_backlog_histlen:0                                     # 已保存数据的有效长度
四、Redis 持久化
redis 支持以下几种不同的方式来完成持久化
- RDB: 它是按照一定的时间周期性的对数据集进行快照备份
- AOF: 它会把服务器接收到的写请求都记录到日志中,在 redis 重启之后会重演日志中的记录。当日志记录过大时,redis 会在后台重写日志记录
- AOF 和 RDB 同时存在于一个 redis 实例中,在这种场景下,当 redis 重启之后,AOF 日志文件将重建数据集,确保它是最完整的。
官方建议两种方式同时使用,也可以根据需求去选择持久化方案
4.1 RDB
在默认情况下,Redis 将数据库快照保存在名字为 dump.rdb 的二进制文件中。
你可以对 Redis 进行设置,让它在“N 秒内数据集至少有 M 个改动”这一条件被满足时,自动保存一次数据集。 也可以通过调用 SAVE 或者 BGSAVE ,手动让 Redis 进行数据集保存操作
比如: 只要满足 60 秒内有至少 1000 个键做了改动,就进行持久化
save 60 1000
当 Redis 需要保存 dump.rdb 文件时,服务器执行以下操作:
- Redis 调用 fork() ,同时拥有父进程和子进程
- 子进程将数据集写入到一个临时 RDB 文件中。
- 当子进程完成对新 RDB 文件的写入时,Redis 用新 RDB 文件替换原来的 RDB 文件,并删除旧的 RDB 文件
这种工作方式称为写时复制(copy-on-write)
4.2 AOF file
1.1 版本开始,Redis 增加了一种完全耐久的持久化方式:AOF 持久化
通过修改配置文件来打开 AOF 功能:
appendonly yes
重启服务之后,每当 Redis 执行一个改变数据集的命令时(比如 SET),这个命令就会被追加到 AOF 文件的末尾。这样当 redis 重启之后就可以重新执行 AOF 文件中的命令来达到恢复数据的目的
AOF 重写和 RDB 创建快照一样,都利用了写时复制机制
以下是 AOF 重写的步骤:
- redis 执行 fork(),现在同时拥有父进程和子进程
- 子进程开始将新 AOF 文件的内容写入到临时文件。
- 对于所有新执行的写入命令,父进程一边将它们累积到一个内存缓存中,一边将这些改动追加到现有 AOF 文件的末尾:这样即使在重写的中途发生停机,现有的 AOF 文件也还是安全的。
- 当子进程完成重写工作时,它给父进程发送一个信号,父进程在接收到信号之后,将内存缓存中的所 有数据追加到新 AOF 文件的末尾
- 现在 Redis 原子地用新文件替换旧文件,之后所有命令都会直接追加到新 AOF 文件的末尾
4.3 AOF 重写
因为 AOF 的运作方式是不断地将命令追加到文件的末尾,所以随着写入命令的不断增加,AOF 文件的体积也会变得越来越大。
举个例子,如果你对一个计数器调用了 100 次 INCR ,那么仅仅是为了保存这个计数器的当前值,AOF 文 件就需要使用 100 条记录(entry)。 然而在实际上,只使用一条 SET 命令已经足以保存计数器的当前值了,其余 99 条记录实际上都是多余的。 为了处理这种情况,
Redis 支持一种特性:可以在不打断服务客户端的情况下,对 AOF 文件进行重 建(rebuild)。执行 BGREWRITEAOF 命令,Redis 将生成一个新的 AOF 文件,这个文件包含重建当前数据集所需的最少命令。
Redis 2.2 需要自己手动执行 BGREWRITEAOF 命令;Redis 2.4 则可以自动触发 AOF 重写
4.4 AOF fsync
redis 允许配置多长时间将数据 fsync 到磁盘中,一共有以下三种方式:
- appendfsync always:每次有新命令追加到 AOF 文件时就执行一次 fsync :非常慢,也非常安全
- appendfsync everysec: 每秒 fsync 一次。快! (和使用 RDB 差不多)
- appendfsync no: 将数据交给系统处理
redis 默认的是 appendfsync everysec,也是官方推荐的
4.5 RDB 切换到 AOF
在 Redis 2.2 或以上版本,可以在不重启的情况下,从 RDB 切换到 AOF
- 为最新的 dump.rdb 文件创建一个备份
- 将备份放到一个安全的地方。
- 执行以下两条命令:
redis-cli> CONFIG SET appendonly yesredis-cli> CONFIG SET save ""
- 确保命令执行之后,数据库键的数量没有问题
- 确保写命令会追加到 AOF 文件末尾
五、Redis Sentinel
Redis Sentinel,即 Redis 哨兵,在 Redis 2.8 版本开始引入。哨兵的核心功能是主节点的自动故障转移
Redis 的 Sentinel 系统用于管理多个 Redis 服务器(instance),该系统执行以下三个任务
- 监控: Sentinel 会不断地检查主服务器和从服务器是否正常运作
- 提醒: 当被监控的某个 Redis 服务器出现问题,Sentinel 可以通过 API 向管理员发送通知
- 自动故障转移: 当一个主服务器不能正常工作时,Sentinel 会开始一次自动 故障迁移操作,它会将其中一个从服务器升级为新的主服务器。当客户端试图连接失效的主服务器时,集群也会向客户端返回 新主服务器的地址,使得集群可以使用新主服务器代替失效服务器
5.1 环境搭建
在部署 sentinel 之前需要先了解的东西:
- 一个健壮的集群至少需要三个 sentinel
- 这三个 sentinel 最好运行在不同的物理机或者虚拟机中
- sentinel + redis 分布式系统并不能保证在故障切换的时候不丢失数据
- 客户端要支持 sentinel,自带的 redis-cli 就支持
- Docker 执行端口映射,可能会破坏 Sentinel 自动发现其他的 sentinel 进程和 master 的 slave 表。
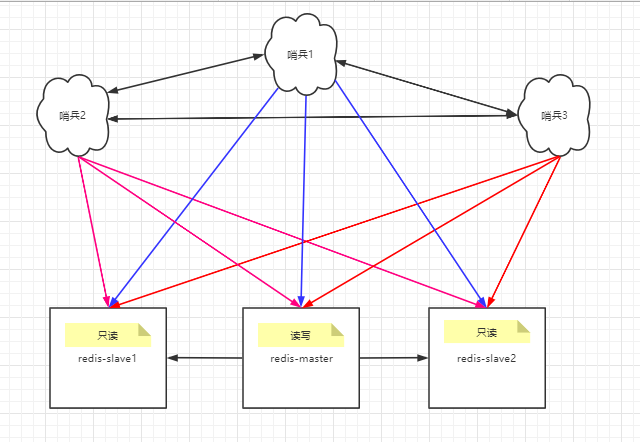
下面这是 sentinel 高可用方案的架构图:
简单的说它由两部分组成,哨兵节点和数据节点
- 哨兵节点: sentinel 系统有一个或多个哨兵组成,它是特殊的 redis 节点,不存储数据
- 数据节点: 主节点和从节点都是数据节点
redis 配置文件
### 主节点:
protected-mode no
port 6379
daemonize yes
#maxmemory 8g
#maxmemory-policy volatile-lru
#maxmenory-samples 10
save ""
#save 900 1
#save 300 10
#save 60 10000
appendonly no
#appendfilename "appendonly.aof"
#appendfsync no
#no-appendfsync-on-rewrite yes
slave-serve-stale-data yes
slave-read-only yes
min-slaves-to-write 1
min-slaves-max-lag 10


### 两个从节点
bind 0.0.0.0
protected-mode no
port 6379
daemonize yes
#maxmemory 8g
#maxmemory-policy volatile-lru
#maxmenory-samples 10
save ""
#save 900 1
#save 300 10
#save 60 10000
appendonly no
#appendfilename "appendonly.aof"
#appendfsync no
#no-appendfsync-on-rewrite yes
slave-serve-stale-data yes
slave-read-only yes
min-slaves-to-write 1
min-slaves-max-lag 10

slaveof 192.168.20.200 6379
sentinel 配置文件
#sentinel deny-scripts-reconfig yes
sentinel deny-scripts-reconfig yes
sentinel monitor mymaster 192.168.20.200 6379 2
sentinel config-epoch mymaster 0
port 26379
dir "/tmp"
daemonize yes
bind 0.0.0.0
启动服务
# 启动redis-server
shell> redis-server redis.conf
# 启动redis-sentinel
# redis-sentinel启动时必须要指定一个配置文件,否则sentinel会拒绝启动
# redis-sentinel有两种启动方式
>第一种方式 shell> redis-sentinel sentinel.conf
>第二种方式 shell> redis-server sentinel.conf --sentinle
检查服务状态
# 在第一个启动的redis中执行
shell> redis-cli
127.0.0.1:6379> INFO REPLICATION
# Replication
role:master
connected_slaves:2
min_slaves_good_slaves:2
slave0:ip=192.168.20.201,port=6379,state=online,offset=214401,lag=0
slave1:ip=192.168.20.202,port=6379,state=online,offset=214401,lag=0
shell> redis-cli -p 26379
127.0.0.1:26379> SENTINEL MASTER mymaster
 9) "flags"
10) "master"
31) "num-slaves"
32) "2"
33) "num-other-sentinels"
34) "2"
5.2 工作原理
5.2.1 主从复制原理
replication_id 和 offset
每个 master 都有一个replication_id和offset
replication_id是一个很大的伪随机字符串,用来标记一个数据集。
offset是一个根据主节点向从节点传递字节数而自增的复制偏移量;offset 用于判断主从节点的数据库状态是否一致:如果二者 offset 相同,则一致;如果 offset 不同,则不一致,此时可以根据两个 offset 找出从节点缺少的那部分数据
缓冲区
复制缓冲区是由 maste 维护的、固定长度的、先进先出(FIFO)的队列,默认大小 1MB。它的作用是备份主节点发送给从节点的数据。不管主节点只有一个从节点还是多个从节点,都只需要一个缓冲区。
在复制进行中时,主节点除了发送写命令给从节点还会发送一份复制缓冲区作为写命令的备份。
除了存储写命令,复制缓冲区还存储了每个字节对应的偏移量,由于缓冲区是一个先进先出(FIFO)的队列,所以它保存的是主节点最近的写命令,达到队列最大长度之后,最早的写命令会被挤出队列。
可以通过配置repl-backlog-size来配置缓冲区大小
主从复制流程
当一个从节点连接到一个主节点时,从节点会根据自身的状态来决定如何调用 PSYNC 命令,
- 如果从节点之前没有执行过
SLAVEOF命令,或最近执行了SLAVEOF NO ONE则从节点向主节点发送 PSYNC ? -1,向主节点请求全量复制 - 如果从节点之前执行过
SLAVEOF命令,则向主节点发送PSYNC <replication-id\> \<offset>,replication-id 为上次复制的主节点的 id,offset 为上次复制结束时保存的偏移量
之后主节点再根据收到的 PSYNC 命令,选择全量还是根据 offset 进行部分复制
这里需要注意一点:
如果从节点发送的 offset 之后的数据已经不在缓冲区了(被挤掉了),则回复+FULLRESYNC <replication-id> <offset>,表示要进行全量复制,其中 replication-id 表示主节点当前的 id,offset 表示主节点当前的 offset。
全量复制
- 主节点运行 bgsave,生成一个 RDB 文件;同时,它还会从客户端接收新的写命令,并将其保存到缓冲区
- 当 bgsave 完成之后,主节点将 RDB 文件传给从节点,从节点将 RDB 文件保存到磁盘中,并开始把它加载到内存中
- 之后主节点会将缓存下来的命令发送给从节点
5.2.2 sentinel 工作原理
从 sentinel 的配置文件来看
sentinel monitor mymaster 192.168.20.200 6379 2
sentinel down-after-milliseconds 30000
sentinel failover-timeout mymaster 180000
sentinel deny-scripts-reconfig yes
sentinel parallel-syncs mymaster 1
sentinel config-epoch mymaster 0
port 26379
dir "/tmp"
daemonize yes
bind 0.0.0.0
sentinel 配置文件第一行,指定它去监视一个名为 mymaster 的主服务器,这个主服务器的 IP 地址为 127.0.0.1,端口号 6379,而且要将这个服务器判定为失效至少需要两个 sentinel 的同意,只要 sentinel 同意的数量不达标,自动迁移就不会执行。并且,无论这个数值设置成多少,一个 sentinel 如果要发起一次故障转移它必须获得大多数 sentinel 的支持,也就是说如果三个 sentinel,只有两个能正常工作,那么这样就绝对不会触发故障转移操作。
sentinel 会周期性的向其他节点发送 ping 命令进行心跳检测,判断是否下线。在心跳检测的定时任务中,如果其他节点超过一定时间没有回复,哨兵节点就会将其进行主观下线. 当哨兵节点判断一个主节点为主观下线状态时,它会通过sentinel is-master-down-by-addr命令询问其他哨兵节点该主节点的状态;如果判断主节点下线的哨兵数量达到一定数量,则对该主节点进行客观下线。
客观下线是对主节点来说才有的概念,如果从节点和哨兵节点发生故障,被哨兵主观下线后,不会再有后续的客观下线和故障转移操作
5.2.3 故障转移
一次故障转移操作由以下步骤组成:
- 发现主服务器已经进入客观下线状态
- 对当前纪元进行自增并尝试在这个纪元中当选。
- 如果当选失败,那么在设定的故障迁移超时时间的两倍之后,重新尝试当选。如果当选成功,那么执行以下步骤
- 选出一个从服务器,并将它升级为主服务器
- 向被选中的从服务器发送
SLAVEOF NO ONE命令,让它转变为主服务器 - 通过发布与订阅功能,将更新后的配置传播给所有其他 Sentinel ,其他 Sentinel 对它们自己的配置进行更新
- 向已下线主服务器的从服务器发送
SLAVEOF命令,让它们去复制新的主服务器。 - 当所有从服务器都已经开始复制新的主服务器时,领头 Sentinel 终止这次故障迁移操作。
Sentinel 使用以下规则来选择新的主服务器:
- 在失效主服务器属下的从服务器当中,那些被标记为主观下线、已断线、或者最后一次回复
PING命 令的时间大于五秒钟的从服务器都会被淘汰。 - 在失效主服务器属下的从服务器当中,那些与失效主服务器连接断开的时长超过
down-after选项指 定的时长十倍的从服务器都会被淘汰。 - 在经历了以上两轮淘汰之后剩下来的从服务器中,我们选出复制偏移量最大的那 个从服务器作为新的主服务器;如果复制偏移量不可用,或者从服务器的复制偏移量相同,那么带有 最小运行 ID 的那个从服务器成为新的主服务器。
5.3 SENTINEL API
5.3.1 PING
这个命令只返回 PONG
127.0.0.1:26379> PING
PONG
5.3.2 SENTINEL masters
列出所有被监视的主服务器,以及主服务器的当前状态
127.0.0.1:26379> SENTINEL masters
1)  1) "name"
    2) "mymaster"
    3) "ip"
    4) "192.168.20.200"
    5) "port"
    6) "6379"
    9) "flags"
   10) "master"
   17) "last-ok-ping-reply"
   18) "213"
   19) "last-ping-reply"
   20) "213"
   25) "role-reported"
   26) "master"
   31) "num-slaves"
   32) "2"
   33) "num-other-sentinels"
   34) "2"
   35) "quorum"
   36) "2"
   37) "failover-timeout"
   38) "180000"
5.3.3 SENTINEL slaves
SENTINEL slaves <master name> 列出给定主服务器的所有从服务器,以及这些从服务器的当前状态
127.0.0.1:26379> SENTINEL slave mymaster
1)  1) "name"
   2) "192.168.20.202:6379"
   3) "ip"
   4) "192.168.20.202"
   5) "port"
   6) "6379"
   9) "flags"
  10) "slave"
  31) "master-link-status"
  32) "ok"
  33) "master-host"
  34) "192.168.20.200"
  35) "master-port"
  36) "6379"
2)  1) "name"
   2) "192.168.20.201:6379"
   3) "ip"
   4) "192.168.20.201"
   5) "port"
   6) "6379"
   9) "flags"
  10) "slave"
  31) "master-link-status"
  32) "ok"
  33) "master-host"
  34) "192.168.20.200"
5.3.4 SENTINEL sentinels
SENTINEL sentinels <master name> 列出给定主服务器的所有 sentinel,以及 sentinel 的当前状态
127.0.0.1:26379> SENTINEL sentinels mymaster
1)  1) "name"
    2) "d7297243629b1482ae5155ba49a80e31a07ae359"
    3) "ip"
    4) "192.168.20.202"
    5) "port"
    6) "26379"
    9) "flags"
   10) "sentinel"
2)  1) "name"
    2) "924db9cb4397fec56fe0438b0c728f43faa5e0e3"
    3) "ip"
    4) "192.168.20.201"
    5) "port"
    6) "26379"
    9) "flags"
   10) "sentinel"
5.3.5 SENTINEL get-master-addr-by-name
SENTINEL get-master-addr-by-name <master name> 返回给定名字的主服务器的 IP 地址和端口号。
127.0.0.1:26379> SENTINEL GET-MASTER-ADDR-BY-NAME mymaster
1) "192.168.20.200"
2) "6379"
5.3.6 SENTINEL reset
SENTINEL reset <pattern> 重置所有名字和给定模式 pattern 相匹配的主服务器。pattern 参数是一个 Glob 风格的模式。重置操作清除主服务器目前的所有状态,包括正在执行中的故障转移,并移除目前已经发现和关联的,主服务器的所有从服务器和 Sentinel
5.3.7 SENTINEL failover
SENTINEL failover <master name> 当主服务器失效时,在不询问其他 Sentinel 意见的情况下,强 制开始一次自动故障迁移(不过发起故障转移的 Sentinel 会向其他 Sentinel 发送一个新的配置,其他 Sentinel 会根据这个配置进行相应的更新)
5.3.8 SENTINEL ckquorum
SENTINEL ckquorum <master name> 检查当前在线的哨兵节点。如果一共有 5 个节点,设置 4 票,但检查后只有 3 节点在线,那一直无法进行监控切换
127.0.0.1:26379> SENTINEL CKQUORUM mymaster
OK 3 usable Sentinels. Quorum and failover authorization can be reached
5.3.9 SENTINEL flushconfig
SENTINEL flushconfig : 强制更新 sentinel 的配置,并包含当前 Sentinel 的状态
发布订阅系统
客户端可以将 Sentinel 看作是一个只提供了订阅功能的 Redis 服务器: 你不可以使用 PUBLISH 命令向这个服务器发送信息, 但你可以用 SUBSCRIBE 命令或者 PSUBSCRIBE 命令, 通过订阅给定的频道来获取相应的事件提醒。
一个频道能够接收和这个频道的名字相同的事件。 比如说, 名为 +sdown 的频道就可以接收所有实例进入主观下线(SDOWN)状态的事件。
通过执行 PSUBSCRIBE *命令可以接收所有事件信息。
以下列出的是客户端可以通过订阅来获得的频道和信息的格式: 第一个英文单词是频道/事件的名字, 其余的是数据的格式。
注意, 当格式中包含 instance details 字样时, 表示频道所返回的信息中包含了以下用于识别目标实例的内容:
<instance-type> <name> <ip> <port> @ <master-name> <master-ip> <master-port>
- +reset-master <instance details>:主服务器已被重置。
- +slave <instance details>: 一个新的从服务器已经被 Sentinel 识别并关联
- +failover-detected <instance details> : 另一个 Sentinel 开始了一次故障转移操作或者一个从服务器转换为主服务器
- +failover-state-reconf-slaves <instance details>: 故障转移状态切换到了 reconf-slaves 状态
- +slave-reconf-sent <instance details>: Leader 的 Sentinel 向实例发送了 SLAVEOF 命令,为实例设置新的主服务器
- +slave-reconf-inprog <instance details>: 实例正在将自己设置为指定主服务器的从服务器,但相应的同步过程仍未完成
- +slave-reconf-done <instance details>: 从服务器已经成功完成对新主服务器的同步
- -dup-sentinel <instance details>: 对给定主服务器进行监视的一个或多个 Sentinel 已经因为重 复出现而被移除——当 Sentinel 实例重启的时候,就会出现这种情况。
- +sentinel <instance details> 一个监视给定主服务器的新 Sentinel 已经被识别并添加。
- +sdown <instance details> 给定的实例现在处于主观下线状态。
- -sdow <instance details> 给定的实例已经不再处于主观下线状态
- +odown <instance details> 给定的实例现在处于客观下线状态
- -odown <instance details> 给定的实例已经不再处于客观下线状态。
- +new-epoch <instance detail> 当前的纪元(epoch)已经被更新。
- +try-failover <instance detail> 一个新的故障迁移操作正在执行中,等待被大多数 Sentinel 选中
- +elected-leader <instance details> 赢得指定纪元的选举,可以进行故障迁移操作了
- +failover-state-select-slave <instance details> 故障转移操作现在处于 select-slave 状 态——Sentinel 正在寻找可以升级为主服务器的从服务器。
- no-good-slave <instance details> Sentinel 操作未能找到适合进行升级的从服务器。Sentinel 会 在一段时间之后再次尝试寻找合适的从服务器来进行升级,又或者直接放弃执行故障转移操作
- selected-slave <instance details> Sentinel 顺利找到适合进行升级的从服务器
- failover-state-send-slaveof-noone <instance details> Sentinel 正在将指定的从服务器升级 为主服务器,等待升级功能完成
- failover-end-for-timeout <instance details> :故障转移因为超时而中止,不过最终所有从服 务器都会开始复制新的主服务器
- failover-end <instance details> 故障转移操作顺利完成。所有从服务器都开始复制新的主服务器了。
- +switch-master <instance details> <old ip> <old port> <new ip> <new port>: 配置变更,主服务器的 IP 和地址已经改变
- +tilt: 进入 tilt 模式
- -tilt: 退出 tilt 模式

 浙公网安备 33010602011771号