
redis
一、NoSQL
1.1.什么是NOSQL
NoSQL(NoSQL = Not Only SQL),意即“不仅仅是SQL”,是一项全新的数据库理念,泛指非关系型的数据库。
随着互联网web2.0网站的兴起,传统的关系数据库在应付web2.0网站,特别是超大规模和高并发的SNS类型的web2.0纯动态网站已经显得力不从心,暴露了很多难以克服的问题,而非关系型的数据库则由于其本身的特点得到了非常迅速的发展。NoSQL数据库的产生就是为了解决大规模数据集合多重数据种类带来的挑战,尤其是大数据应用难题。
1.1.1. NOSQL和关系型数据库比较
优点:
1)成本:nosql数据库简单易部署,基本都是开源软件,不需要像使用oracle那样花费大量成本购买使用,相比关系型数据库价格便宜。
2)查询速度:nosql数据库将数据存储于缓存之中,关系型数据库将数据存储在硬盘中,自然查询速度远不及nosql数据库。
3)存储数据的格式:nosql的存储格式是key,value形式、文档形式、图片形式等等,所以可以存储基础类型以及对象或者是集合等各种格式,而数据库则只支持基础类型。
4)扩展性:关系型数据库有类似join这样的多表查询机制的限制导致扩展很艰难。
缺点:
1)维护的工具和资料有限,因为nosql是属于新的技术,不能和关系型数据库10几年的技术同日而语。
2)不提供对sql的支持,如果不支持sql这样的工业标准,将产生一定用户的学习和使用成本。
3)不提供关系型数据库对事务的处理。
1.1.2. 非关系型数据库的优势:
1)性能NOSQL是基于键值对的,可以想象成表中的主键和值的对应关系,而且不需要经过SQL层的解析,所以性能非常高。
2)可扩展性同样也是因为基于键值对,数据之间没有耦合性,所以非常容易水平扩展。
1.1.3. 关系型数据库的优势:
1)复杂查询可以用SQL语句方便的在一个表以及多个表之间做非常复杂的数据查询。
2)事务支持使得对于安全性能很高的数据访问要求得以实现。对于这两类数据库,对方的优势就是自己的弱势,反之亦然。
1.1.4. 总结
关系型数据库与NoSQL数据库并非对立而是互补的关系,即通常情况下使用关系型数据库,在适合使用NoSQL的时候使用NoSQL数据库,
让NoSQL数据库对关系型数据库的不足进行弥补。
一般会将数据存储在关系型数据库中,在nosql数据库中备份存储关系型数据库的数据
1.2.主流的NOSQL产品
• 键值(Key-Value)存储数据库
相关产品: Tokyo Cabinet/Tyrant、Redis、Voldemort、Berkeley DB
典型应用: 内容缓存,主要用于处理大量数据的高访问负载。
数据模型: 一系列键值对
优势: 快速查询
劣势: 存储的数据缺少结构化
• 列存储数据库
相关产品:Cassandra, HBase, Riak
典型应用:分布式的文件系统
数据模型:以列簇式存储,将同一列数据存在一起
优势:查找速度快,可扩展性强,更容易进行分布式扩展
劣势:功能相对局限
• 文档型数据库
相关产品:CouchDB、MongoDB
典型应用:Web应用(与Key-Value类似,Value是结构化的)
数据模型: 一系列键值对
优势:数据结构要求不严格
劣势: 查询性能不高,而且缺乏统一的查询语法
• 图形(Graph)数据库
相关数据库:Neo4J、InfoGrid、Infinite Graph
典型应用:社交网络
数据模型:图结构
优势:利用图结构相关算法。
劣势:需要对整个图做计算才能得出结果,不容易做分布式的集群方案。
1.3 什么是Redis:redis是一款高性能的NOSQL系列的非关系型数据库
   Redis是用C语言开发的一个开源的高性能键值对(key-value)数据库,官方提供测试数据,50个并发执行100000个请求,读的速度是110000次/s,写的速度是81000次/s ,且Redis通过提供多种键值数据类型来适应不同场景下的存储需求,目前为止Redis支持的键值数据类型如下:
       1) 字符串类型 string
       2) 哈希类型 hash
       3) 列表类型 list
       4) 集合类型 set
       5) 有序集合类型 sortedset
    1.3.1 redis的应用场景
•   缓存(数据查询、短连接、新闻内容、商品内容等等)
•   聊天室的在线好友列表
•   任务队列。(秒杀、抢购、12306等等)
•   应用排行榜
•   网站访问统计
•   数据过期处理(可以精确到毫秒
•   分布式集群架构中的session分离
二、Redis安装配置
(1)windows下的 Programe Files 相当于 Linux下的usr
  1. 官网:https://redis.io
   2. 中文网:http://www.redis.net.cn/
   3. 解压直接可以使用:
        * redis.windows.conf:配置文件
        * redis-cli.exe:redis的客户端
        * redis-server.exe:redis服务器端
(2)Linux下,对刚安装的软件做任何操作前,一定要先将原配置文件备份(主要玩配置文件)
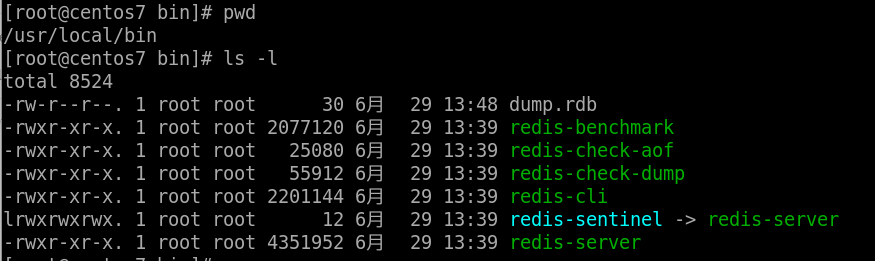
1、安装完的redis在 /usr/local/bin

2、启动redis
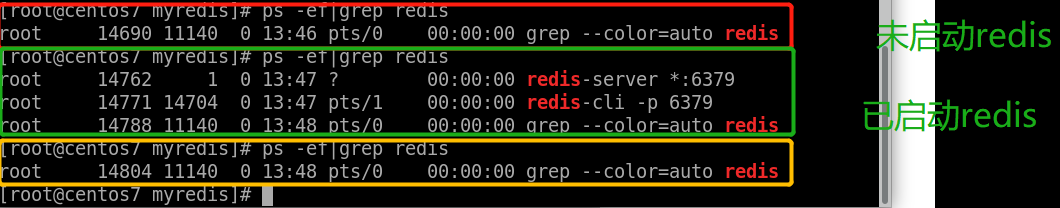
(1)查询 Redis 进程是否启动
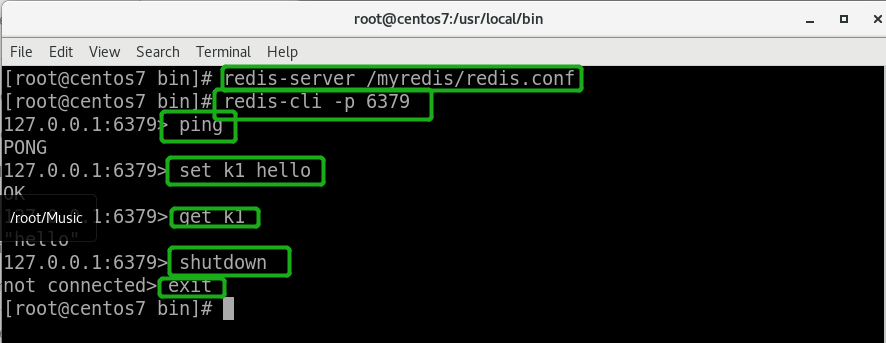
(2)在usr/local/bin下启动
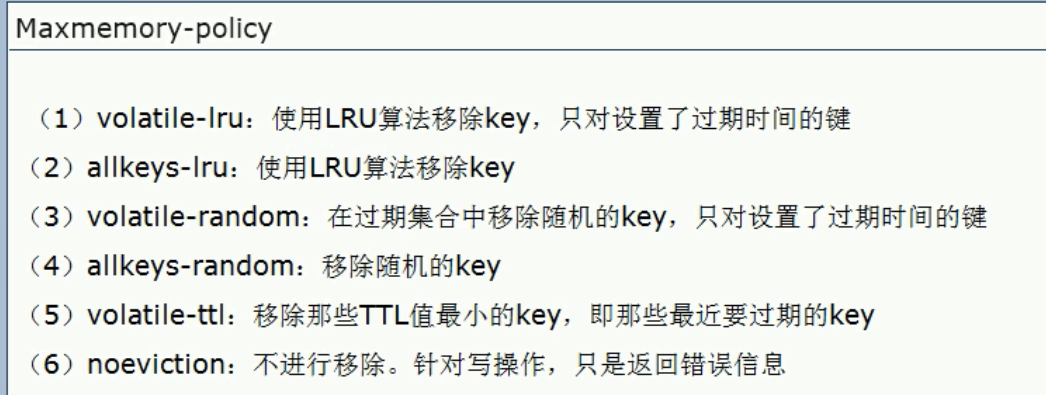
3、redis最大内存过期策略
【lru】lastes recently used,最近最少使用
【ttl】time to leave,即将要过期
4、常见配置redis.conf介绍


//参数说明
redis.conf 配置项说明如下:
1. Redis默认不是以守护进程的方式运行,可以通过该配置项修改,使用yes启用守护进程
  daemonize no
2. 当Redis以守护进程方式运行时,Redis默认会把pid写入/var/run/redis.pid文件,可以通过pidfile指定
  pidfile /var/run/redis.pid
3. 指定Redis监听端口,默认端口为6379,作者在自己的一篇博文中解释了为什么选用6379作为默认端口,因为6379在手机按键上MERZ对应的号码,而MERZ取自意大利歌女Alessia Merz的名字
  port 6379
4. 绑定的主机地址
  bind 127.0.0.1
5.当 客户端闲置多长时间后关闭连接,如果指定为0,表示关闭该功能
  timeout 300
6. 指定日志记录级别,Redis总共支持四个级别:debug、verbose、notice、warning,默认为verbose
  loglevel verbose
7. 日志记录方式,默认为标准输出,如果配置Redis为守护进程方式运行,而这里又配置为日志记录方式为标准输出,则日志将会发送给/dev/null
  logfile stdout
8. 设置数据库的数量,默认数据库为0,可以使用SELECT <dbid>命令在连接上指定数据库id
  databases 16
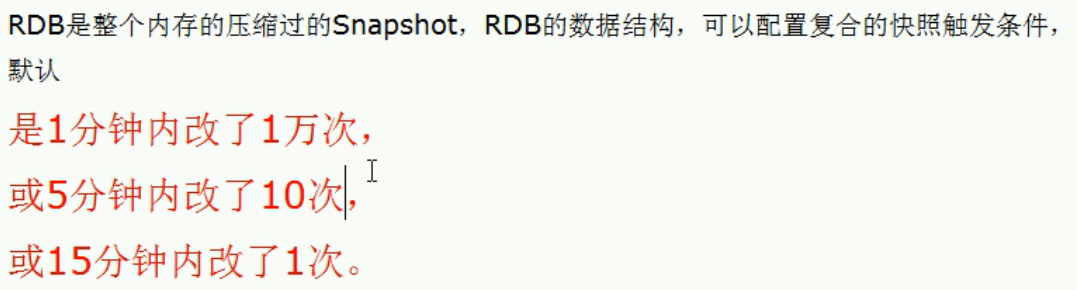
9. 指定在多长时间内,有多少次更新操作,就将数据同步到数据文件,可以多个条件配合
  save <seconds> <changes>
  Redis默认配置文件中提供了三个条件:
  save 900 1
  save 300 10
  save 60 10000
  分别表示900秒(15分钟)内有1个更改,300秒(5分钟)内有10个更改以及60秒内有10000个更改。

10. 指定存储至本地数据库时是否压缩数据,默认为yes,Redis采用LZF压缩,如果为了节省CPU时间,可以关闭该选项,但会导致数据库文件变的巨大
  rdbcompression yes
11. 指定本地数据库文件名,默认值为dump.rdb
  dbfilename dump.rdb
12. 指定本地数据库存放目录
  dir ./
13. 设置当本机为slav服务时,设置master服务的IP地址及端口,在Redis启动时,它会自动从master进行数据同步
  slaveof <masterip> <masterport>
14. 当master服务设置了密码保护时,slav服务连接master的密码
  masterauth <master-password>
15. 设置Redis连接密码,如果配置了连接密码,客户端在连接Redis时需要通过AUTH <password>命令提供密码,默认关闭
  requirepass foobared
16. 设置同一时间最大客户端连接数,默认无限制,Redis可以同时打开的客户端连接数为Redis进程可以打开的最大文件描述符数,如果设置 maxclients 0,表示不作限制。当客户端连接数到达限制时,Redis会关闭新的连接并向客户端返回max number of clients reached错误信息
  maxclients 128
17. 指定Redis最大内存限制,Redis在启动时会把数据加载到内存中,达到最大内存后,Redis会先尝试清除已到期或即将到期的Key,当此方法处理 后,仍然到达最大内存设置,将无法再进行写入操作,但仍然可以进行读取操作。Redis新的vm机制,会把Key存放内存,Value会存放在swap区
  maxmemory <bytes>
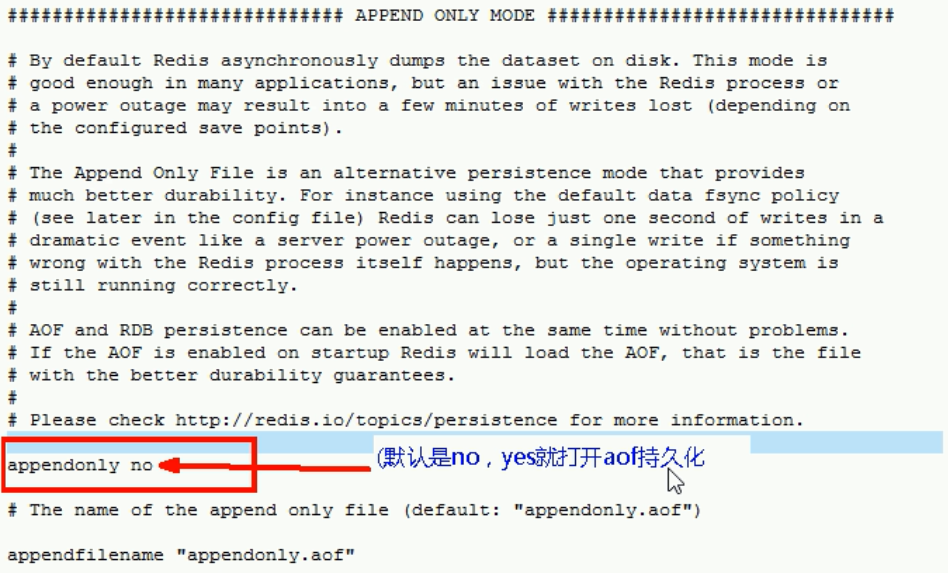
18. 指定是否在每次更新操作后进行日志记录,Redis在默认情况下是异步的把数据写入磁盘,如果不开启,可能会在断电时导致一段时间内的数据丢失。因为 redis本身同步数据文件是按上面save条件来同步的,所以有的数据会在一段时间内只存在于内存中。默认为no
  appendonly no
19. 指定更新日志文件名,默认为appendonly.aof
   appendfilename appendonly.aof
20. 指定更新日志条件,共有3个可选值:
  no:表示等操作系统进行数据缓存同步到磁盘(快)
  always:表示每次更新操作后手动调用fsync()将数据写到磁盘(慢,安全)
  everysec:表示每秒同步一次(折衷,默认值)
  appendfsync everysec

21. 指定是否启用虚拟内存机制,默认值为no,简单的介绍一下,VM机制将数据分页存放,由Redis将访问量较少的页即冷数据swap到磁盘上,访问多的页面由磁盘自动换出到内存中(在后面的文章我会仔细分析Redis的VM机制)
   vm-enabled no
22. 虚拟内存文件路径,默认值为/tmp/redis.swap,不可多个Redis实例共享
   vm-swap-file /tmp/redis.swap
23. 将所有大于vm-max-memory的数据存入虚拟内存,无论vm-max-memory设置多小,所有索引数据都是内存存储的(Redis的索引数据 就是keys),也就是说,当vm-max-memory设置为0的时候,其实是所有value都存在于磁盘。默认值为0
   vm-max-memory 0
24. Redis swap文件分成了很多的page,一个对象可以保存在多个page上面,但一个page上不能被多个对象共享,vm-page-size是要根据存储的 数据大小来设定的,作者建议如果存储很多小对象,page大小最好设置为32或者64bytes;如果存储很大大对象,则可以使用更大的page,如果不 确定,就使用默认值
   vm-page-size 32
25. 设置swap文件中的page数量,由于页表(一种表示页面空闲或使用的bitmap)是在放在内存中的,,在磁盘上每8个pages将消耗1byte的内存。
   vm-pages 134217728
26. 设置访问swap文件的线程数,最好不要超过机器的核数,如果设置为0,那么所有对swap文件的操作都是串行的,可能会造成比较长时间的延迟。默认值为4
   vm-max-threads 4
27. 设置在向客户端应答时,是否把较小的包合并为一个包发送,默认为开启
  glueoutputbuf yes
28. 指定在超过一定的数量或者最大的元素超过某一临界值时,采用一种特殊的哈希算法
  hash-max-zipmap-entries 64
  hash-max-zipmap-value 512
29. 指定是否激活重置哈希,默认为开启(后面在介绍Redis的哈希算法时具体介绍)
  activerehashing yes
30. 指定包含其它的配置文件,可以在同一主机上多个Redis实例之间使用同一份配置文件,而同时各个实例又拥有自己的特定配置文件
  include /path/to/local.conf
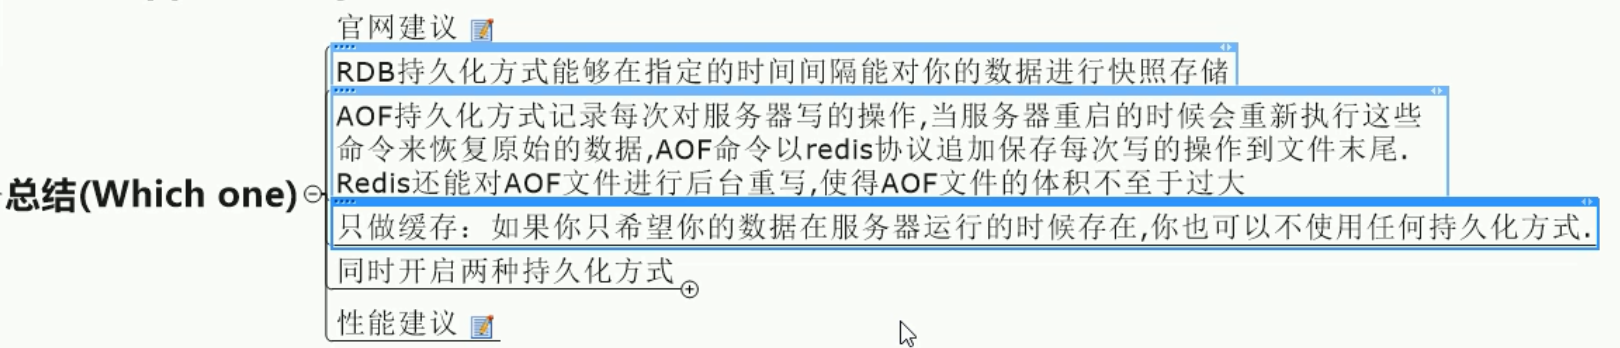
5、redis持久化
(1)RDB(redis database)
(2)AOF(Append only life)
# 性能建议

因为RDB文件只用作后备用途,建议只在Slave上持久化RDB文件,而且只要15分钟备份一次就够了,只保留save 900 1这条规则。


如果Enalbe AOF,好处是在最恶劣情况下也只会丢失不超过两秒数据,启动脚本较简单只load自己的AOF文件就可以了。代价一是带来了持续的IO,二是AOF rewrite的最后将rewrite过程中产生的新数据写到新文件造成的阻塞几乎是不可避免的。只要硬盘许可,应该尽量减少AOF rewrite的频率,AOF重写的基础大小默认值64M太小了,可以设到5G以上。默认超过原大小100%大小时重写可以改到适当的数值。


如果不Enable AOF ,仅靠Master-Slave Replication 实现高可用性也可以。能省掉一大笔IO也减少了rewrite时带来的系统波动。代价是如果Master/Slave同时倒掉,会丢失十几分钟的数据,启动脚本也要比较两个Master/Slave中的RDB文件,载入较新的那个。新浪微博就选用了这种架构
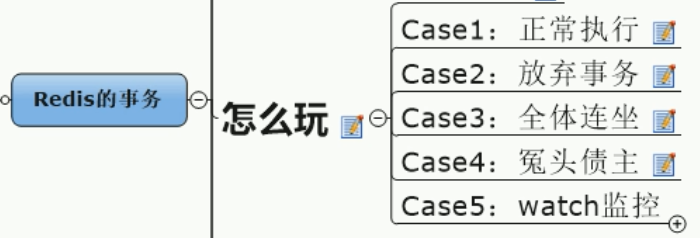
6、事务
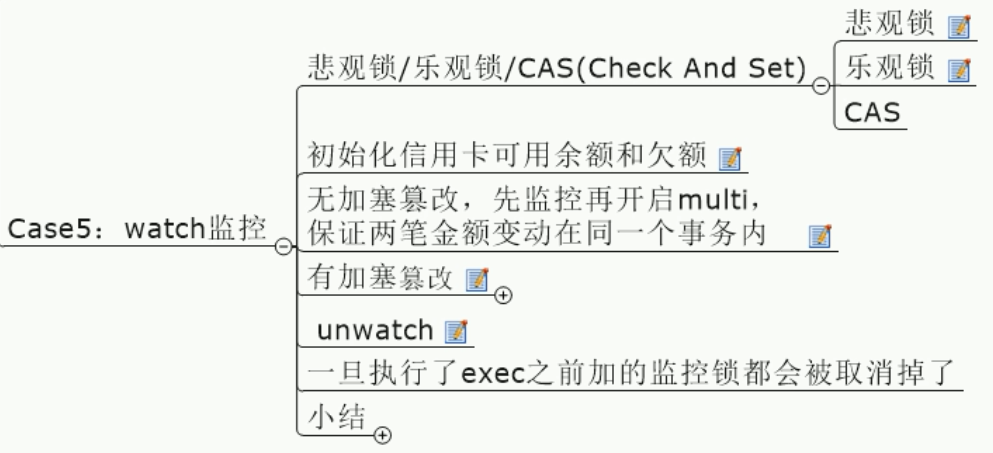
监控:watch key
开启:以MULTI开始一个事务
入队:将多个命令入队到事务中,接到这些命令并不会立即执行,而是放到等待执行的事务队列里面
执行:由EXEC命令触发事务
回滚:discard
取消监控:unwach key
【特性】
(1)没有隔离级别的概念:队列中的命令没有提交之前都不会实际的被执行,因为事务提交前任何指令都不会被实际执行,
也就不存在”事务内的查询要看到事务里的更新,在事务外查询不能看到”这个让人万分头痛的问题
(2)不保证原子性:redis同一个事务中如果有一条命令执行失败,其后的命令仍然会被执行,没有回滚
7、主从复制,(从)读(主)写分离,容灾恢复
【复制原理】
(1)slave启动成功连接到master后会发送一个sync命令
(2)Master接到命令启动后台的存盘进程,同时收集所有接收到的用于修改数据集命令,在后台进程执行完毕之后,master将传送整个数据文件到slave,以完成一次完全同步
(3)全量复制:而slave服务在接收到数据库文件数据后,将其存盘并加载到内存中。
(4)增量复制:Master继续将新的所有收集到的修改命令依次传给slave,完成同步
(5)但是只要是重新连接master,一次完全同步(全量复制)将被自动执行

【原则】—— 配从不配主
(1)slaveof 主机IP 端口
(2)info replication :查看当前状态
(1)一主二从
(2)薪火相传(自动 sync,79-80-81,80还是slave)
(3)反客为主(一主二从【79-80,79-81】的规则下,主机-79 shutdown,假设从机slave-80 执行 slaveof no one,反客为主;从机-81可以选择跟新的主机-80混,另立山头;这是原来的主机-79有重新开启了,但是只是光杆司令了,下边没有slave 了)
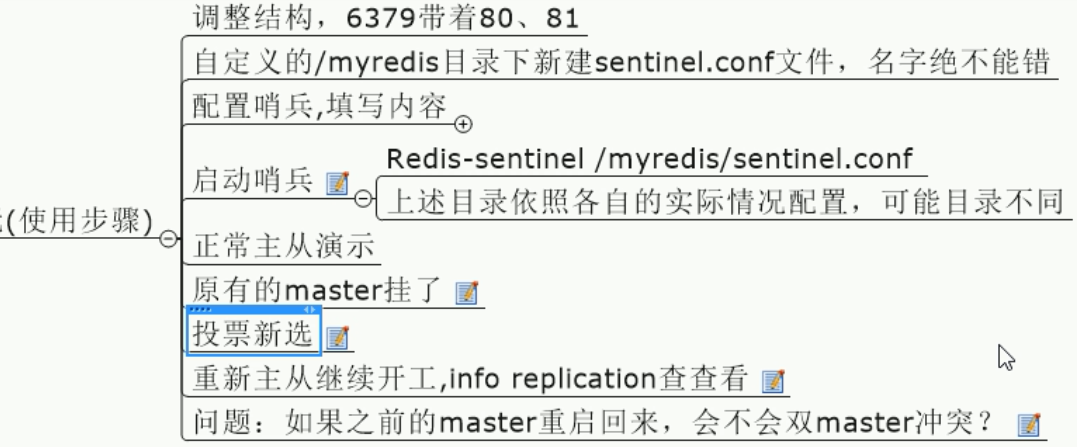
(4)“哨兵”模式 -- sentinel(反客为主 自动版,原来的主机master shutdown了,启动以后会被哨兵自动变成新master的slave)
(5)复制的缺点——复制延时
三、命令操作
    0. redis的数据结构:
        * redis存储的是:key,value格式的数据,其中key都是字符串,value有5种不同的数据结构
            * value的数据结构:
                1) 字符串类型 string
                2) 哈希类型 hash : map格式
                3) 列表类型 list : linkedlist格式。支持重复元素
                4) 集合类型 set  : 不允许重复元素
                5) 有序集合类型 sortedset:不允许重复元素,且元素有顺序
1. redis键(key):
-
- keys * , keys key??(模糊查询)
- exists key的名字,判断某个key是否存在
- move key db --->当前库就没有了,被移除了
- expire key 秒钟:为给定的key设置过期时间
- ttl key 查看还有多少秒过期,-1表示永不过期,-2表示已过期
- type key 查看你的key是什么类型
- select DB 切换DB
- FLUSHDB 删除当前库
    2. 字符串类型 string
        1. 存储: set key value
            127.0.0.1:6379> set username zhangsan
            OK
        2. 获取: get key
            127.0.0.1:6379> get username
            "zhangsan"
        3. 删除: del key
            127.0.0.1:6379> del age
            (integer) 1
(1)set/get/del/append/strlen

(2)Incr/decr/incrby/decrby,一定要是数字才能进行加减

(3)getrange/setrange
// getrange:获取指定区间范围内的值,类似between......and的关系从零到负一表示全部

(4)setex(set with expire)键秒值/   setnx(set if not exist)
// setex:设置带过期时间的key,动态设置。
// setex 键 秒值 真实值

(5) mset/mget/msetnx
// mset:同时设置一个或多个 key-value 对。
// mget:获取所有(一个或多个)给定 key 的值。
// msetnx:同时设置一个或多个 key-value 对,当且仅当所有给定 key 都不存在。

(6) getset(先get再set)
//getset:将给定 key 的值设为 value ,并返回 key 的旧值(old value)。
// 简单一句话,先get然后立即set
    3. 哈希类型 hash
        1. 存储: KV模式不变,但V是一个键值对
        hset key field value
            127.0.0.1:6379> hset myhash username lisi
            (integer) 1
            127.0.0.1:6379> hset myhash password 123
            (integer) 1
        2. 获取:
            * hget key field: 获取指定的field对应的值
                127.0.0.1:6379> hget myhash username
                "lisi"
            * hgetall key:获取所有的field和value
                127.0.0.1:6379> hgetall myhash
                1) "username"
                2) "lisi"
                3) "password"
                4) "123"
        3. 删除: hdel key field
            127.0.0.1:6379> hdel myhash username
            (integer) 1
  hset/hget/hmset/hmget/hgetall/hdel

 hlen

 hexists key 在key里面的某个值的key

 hkeys/hvals

 hincrby / hincrbyfloat

 hsetnx:不存在赋值,存在了无效。
    4. 列表类型 list【双向链表】:可以添加一个元素到列表的头部(左边)或者尾部(右边)
        1. 添加:
            1. lpush key value: 将元素加入列表左边

            2. rpush key value:将元素加入列表右边

                127.0.0.1:6379> lpush myList a
                (integer) 1
                127.0.0.1:6379> lpush myList b
                (integer) 2
                127.0.0.1:6379> rpush myList c
                (integer) 3
        2. 获取:
            * lrange key start end :范围获取
                127.0.0.1:6379> lrange myList 0 -1
                1) "b"
                2) "a"
                3) "c"
        3. 删除:
            * lpop key: 删除列表最左边的元素,并将元素返回
            * rpop key: 删除列表最右边的元素,并将元素返回
 lindex,按照索引下标获得元素(从上到下)

 llen

 lrem key N  :删N个value

 ltrim key 开始index 结束index,截取指定范围的值后再赋值给key

 rpoplpush 源列表 目的列表

 lset key index value

 linsert key  before/after 值1 值2

它是一个字符串链表,left、right都可以插入添加;
如果键不存在,创建新的链表;
如果键已存在,新增内容;
如果值全移除,对应的键也就消失了。
链表的操作无论是头和尾效率都极高,但假如是对中间元素进行操作,效率就很惨淡了。
    5. 集合类型 set : 不允许重复元素
        1. 存储:sadd key value
            127.0.0.1:6379> sadd myset a
            (integer) 1
            127.0.0.1:6379> sadd myset a
            (integer) 0
        2. 获取:smembers key:获取set集合中所有元素
            127.0.0.1:6379> smembers myset
            1) "a"
        3. 删除:srem key value:删除set集合中的某个元素
            127.0.0.1:6379> srem myset a
            (integer) 1
 sadd/smembers/sismember

 scard,获取集合里面的元素个数

 srem key value 删除集合中元素

 srandmember key 某个整数(随机出几个数)

 spop key 随机出栈

 smove key1 key2 在key1里某个值      作用是将key1里的某个值赋给key2

差集:sdiff
交集:sinter
并集:sunion
6. 有序集合类型 sortedset:不允许重复元素,且元素有顺序.
每个元素都会关联一个double类型的分数。redis正是通过分数来为集合中的成员进行从小到大的排序。
1. 存储:zadd key score value
127.0.0.1:6379> zadd mysort 60 zhangsan
(integer) 1
127.0.0.1:6379> zadd mysort 50 lisi
(integer) 1
127.0.0.1:6379> zadd mysort 80 wangwu
(integer) 1
2. 获取:zrange key start end [withscores]
127.0.0.1:6379> zrange mysort 0 -1
1) "lisi"
2) "zhangsan"
3) "wangwu"
127.0.0.1:6379> zrange mysort 0 -1 withscores
1) "zhangsan"
2) "60"
3) "wangwu"
4) "80"
5) "lisi"
6) "500"
3. 删除:zrem key value
127.0.0.1:6379> zrem mysort lisi
(integer) 1
 zadd/zrange  withscores

 zrangebyscore key 开始score 结束score

 zrem key 某score下对应的value值,作用是删除元素

 zcard/zcount key score区间/zrank key values值,作用是获得下标值/zscore key 对应值,获得分数

 zrevrank key values值,作用是逆序获得下标值

 zrevrange

 zrevrangebyscore  key 结束score 开始score
4. 持久化
1. redis是一个内存数据库,当redis服务器重启,或者电脑重启,数据会丢失,我们可以将redis内存中的数据持久化保存到硬盘的文件中。
2. redis持久化机制:
1. RDB:默认方式,不需要进行配置,默认就使用这种机制
* 在一定的间隔时间中,检测key的变化情况,然后持久化数据
1. 编辑redis.windwos.conf文件
# after 900 sec (15 min) if at least 1 key changed
save 900 1
# after 300 sec (5 min) if at least 10 keys changed
save 300 10
# after 60 sec if at least 10000 keys changed
save 60 10000
2. 重新启动redis服务器,并指定配置文件名称
D:\JavaWeb2018\day23_redis\资料\redis\windows-64\redis-2.8.9>redis-server.exe redis.windows.conf
2. AOF:日志记录的方式,可以记录每一条命令的操作。可以每一次命令操作后,持久化数据
1. 编辑redis.windwos.conf文件
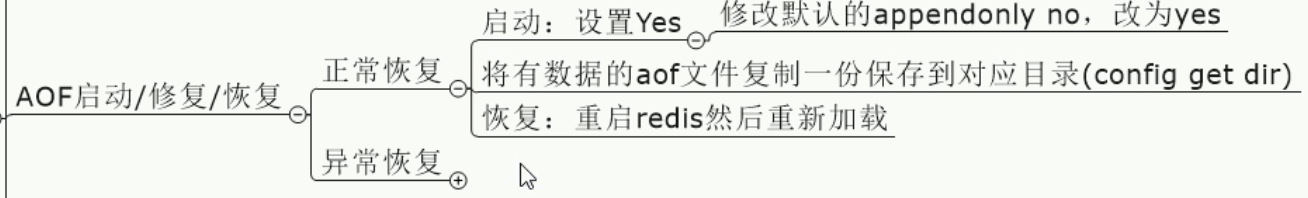
appendonly no(关闭aof) --> appendonly yes (开启aof)
# appendfsync always : 每一次操作都进行持久化
appendfsync everysec : 每隔一秒进行一次持久化
# appendfsync no : 不进行持久化
5. Java客户端 Jedis
* Jedis: 一款java操作redis数据库的工具.
* 使用步骤:
1. 下载jedis的jar包
2. 使用
//1. 获取连接
Jedis jedis = new Jedis("localhost",6379);
//2. 操作
jedis.set("username","zhangsan");
//3. 关闭连接
jedis.close();
* Jedis操作各种redis中的数据结构
1) 字符串类型 string
set
get
//1. 获取连接
Jedis jedis = new Jedis();//如果使用空参构造,默认值 "localhost",6379端口
//2. 操作
//存储
jedis.set("username","zhangsan");
//获取
String username = jedis.get("username");
System.out.println(username);
//可以使用setex()方法存储可以指定过期时间的 key value
jedis.setex("activecode",20,"hehe");//将activecode:hehe键值对存入redis,并且20秒后自动删除该键值对
//3. 关闭连接
jedis.close();
2) 哈希类型 hash : map格式
hset
hget
hgetAll
//1. 获取连接
Jedis jedis = new Jedis();//如果使用空参构造,默认值 "localhost",6379端口
//2. 操作
// 存储hash
jedis.hset("user","name","lisi");
jedis.hset("user","age","23");
jedis.hset("user","gender","female");
// 获取hash
String name = jedis.hget("user", "name");
System.out.println(name);
// 获取hash的所有map中的数据
Map<String, String> user = jedis.hgetAll("user");
            // keyset
            Set<String> keySet = user.keySet();
            for (String key : keySet) {
                //获取value
                String value = user.get(key);
                System.out.println(key + ":" + value);
            }

            //3. 关闭连接
            jedis.close();
        3) 列表类型 list : linkedlist格式。支持重复元素
            lpush / rpush
            lpop / rpop
            lrange start end : 范围获取

             //1. 获取连接
            Jedis jedis = new Jedis();//如果使用空参构造,默认值 "localhost",6379端口
            //2. 操作
            // list 存储
            jedis.lpush("mylist","a","b","c");//从左边存
            jedis.rpush("mylist","a","b","c");//从右边存

            // list 范围获取
            List<String> mylist = jedis.lrange("mylist", 0, -1);
            System.out.println(mylist);

            // list 弹出
            String element1 = jedis.lpop("mylist");//c
            System.out.println(element1);

            String element2 = jedis.rpop("mylist");//c
            System.out.println(element2);

            // list 范围获取
            List<String> mylist2 = jedis.lrange("mylist", 0, -1);
            System.out.println(mylist2);

            //3. 关闭连接
            jedis.close();
4) 集合类型 set : 不允许重复元素
sadd
smembers:获取所有元素
//1. 获取连接
Jedis jedis = new Jedis();//如果使用空参构造,默认值 "localhost",6379端口
//2. 操作
// set 存储
jedis.sadd("myset","java","php","c++");
// set 获取
Set<String> myset = jedis.smembers("myset");
System.out.println(myset);
//3. 关闭连接
jedis.close();
5) 有序集合类型 sortedset:不允许重复元素,且元素有顺序
zadd
zrange
//1. 获取连接
Jedis jedis = new Jedis();//如果使用空参构造,默认值 "localhost",6379端口
//2. 操作
// sortedset 存储
jedis.zadd("mysortedset",3,"亚瑟");
jedis.zadd("mysortedset",30,"后裔");
jedis.zadd("mysortedset",55,"孙悟空");
// sortedset 获取
Set<String> mysortedset = jedis.zrange("mysortedset", 0, -1);
System.out.println(mysortedset);
//3. 关闭连接
jedis.close();
* jedis连接池: JedisPool
* 基础使用:
//1. 创建JedisPool连接池对象 //2. 调用方法 getResource()方法获取Jedis连接 //0.创建一个配置对象 JedisPoolConfig config = new JedisPoolConfig(); config.setMaxTotal(50); config.setMaxIdle(10); //1.创建Jedis连接池对象 JedisPool jedisPool = new JedisPool(config,"localhost",6379); //2.获取连接 Jedis jedis = jedisPool.getResource(); //3. 使用 jedis.set("hehe","heihei"); //4. 关闭 归还到连接池中 jedis.close();
* ——> 封装成连接池工具类
public class JedisPoolUtils { private static JedisPool jedisPool; static{ //读取配置文件 InputStream is = JedisPoolUtils.class.getClassLoader().getResourceAsStream("jedis.properties"); //创建Properties对象 Properties pro = new Properties(); //关联文件 try { pro.load(is); } catch (IOException e) { e.printStackTrace(); } //获取数据,设置到JedisPoolConfig中 JedisPoolConfig config = new JedisPoolConfig(); config.setMaxTotal(Integer.parseInt(pro.getProperty("maxTotal"))); config.setMaxIdle(Integer.parseInt(pro.getProperty("maxIdle"))); //初始化JedisPool jedisPool = new JedisPool(config,pro.getProperty("host"),Integer.parseInt(pro.getProperty("port"))); } /** * 获取连接方法 */ public static Jedis getJedis(){ return jedisPool.getResource(); } }
https://blog.csdn.net/hellozpc/article/details/81267030#6RedisHash_349
视频链接:
https://www.bilibili.com/video/av59604203
配套资料:
链接:https://pan.baidu.com/s/1h1AyTWLFVPDnpgOZfBYMaw
提取码:cn81

 浙公网安备 33010602011771号