
数据库
数据库
一、绪论
课程内容
- 基础篇:学习数据库相关基础概念和技术
- 设计篇:如何设计数据库
- 系统篇:数据库在系统中的作用
1.1 数据库系统概述
1.1.1 数据库的4个基本概念
数据(Data): 是数据库中存储的基本对象
- 数据的定义:描述事物的符号记录
- 数据的种类:数字、 文字、图形、图像、音频、视频
- 数据是基础:数据 - 信息 - 知识 - 智能
数据库(Database, DB): 是长期储存在计算机内、有组织的、可共享的大量数据的集合
数据库的基本特点:见1.1.3
数据库管理系统(DBMS) :位于用户与操作系统之间的一层数据管理软件
-
DBMS用途:科学地组织和存储数据、高效地获取和维护数据
-
DBMS主要功能:
- 数据定义功能:提供数据定义语言(DDL),定义数据库中的数据对象
- 数据操纵功能:提供数据操纵语言(DML),操纵数据库中的数据对象(增删改查)
- 数据控制功能:提供数据控制语言(DCL),限制数据库中的数据对象(什么样的数据可以输入,什么样的数据可供查询)
数据库系统(Database System, DBS): 上述的总和
数据库系统的构成:
- 数据库
- 数据库管理系统
- 应用程序
- 数据库管理员
本地架构:
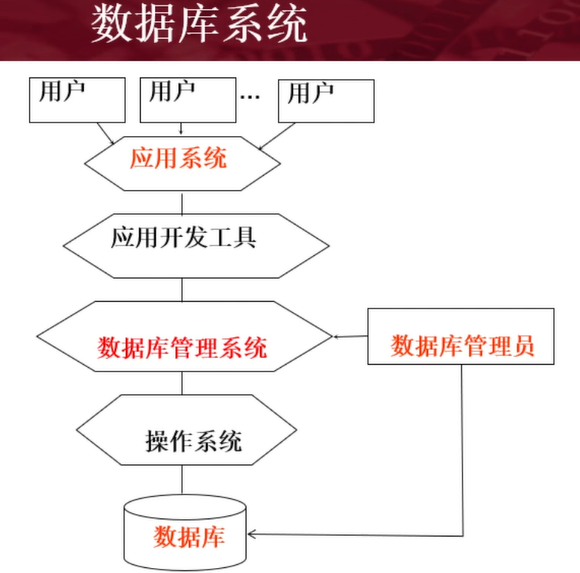
远端架构:

1.1.2 数据管理技术的产生和发展
数据管理技术的发展过程:
- 人工管理阶段(20世纪50年代中之前)
背景:无直接存储设备,没有操作系统,采用批处理 - 文件系统阶段(20世纪50年代末—60年代中)
背景:有磁盘,有文件系统,联机实时处理/批处理
缺点:冗余多、可能有不一致性、不能并发操作、不能回轨 - 数据库系统阶段(20世纪60年代末—现在)
数据库管理技术的发展动力:
- 应用需求的推动
- 计算机硬件的发展
- 计算机软件的发展
1.1.3 数据库系统的特点
数据结构化: 数据按统一的数据结构存放,用数据模型进行描述,和程序无关
数据的共享性高,冗余度低且易扩充: 数据面向整个系统,可以被多个用户、应用共享使用
数据独立性高: 抽象程度高,应用程序与数据库是独立的。包含物理独立性和逻辑独立性两部分
数据由数据库管理系统统一管理和控制: DBMS可以提供以下功能
- 数据的安全性(Security)保护
- 数据的完整性(Integrity)检查
- 并发(Concurrency)控制
- 数据库恢复(Recovery)
1.2 数据模型
数据模型是对现实世界数据特征的抽象,通俗地讲数据模型就是现实世界的模拟。数据模型是数据库系统的核心和基础。
数据模型应满足三方面要求:
- 能比较真实地模拟现实世界
- 容易被人理解
- 便于在计算机上实现
1.2.1 两类数据模型
数据模型分为两类:
-
概念模型: 也称信息模型,它是按用户的观点来对数据和信息建模,用于数据库设计
可以简单理解为,概念模型就是把现实世界的关系画出来 -
逻辑模型和物理模型:
逻辑模型主要包括网状模型、层次模型、关系模型、面向对象数据模型、对象关系数据模型等。按计算机系统的观点对数据建模,用于DBMS实现。主要指的是,我们在设计数据库的环节中,使用的是哪类数据结构。 完成的是把图变为二维表
物理模型是对数据底层的抽象,描述数据在系统内部的表示方式和存取方式,在磁盘或磁带上的存储方式和存取方式。主要指的是,存储的数据怎样在磁盘上映射为0和1。 完成的是把二维表变成0和1
1.2.2 概念模型
概念模型的一种表示方法:实体 - 联系方法(E-R图)
信息世界中的基本概念:
- 实体(Entity):客观存在并可互相区别的事物称为实体。可以是具体的人事物,也可以是抽象的概念。
- 属性(Attribute):实体所具有的某一特性称为属性。一个实体可以由若干个属性来刻画
- 键(Key):位移标识实体的属性集称为键
- 联系(Relationship):实体之间的关系称为联系。实体之间的联系有一对一、一对多和多对多等多种类型
1.2.3 数据模型的组成要素
数据结构: 描述数据库的组成对象,以及对象之间的联系。数据结构是对系统静态特性的描述。
数据结构描述的内容:
- 与对象的类型、内容、性质有关
- 与数据之间的联系有关
数据操作: 对数据库中各种对象的实力允许执行的操作的集合,包括操作及有关的操作规则。 增删改查
数据的完整性约束条件
数据模型对完整性约束条件的定义:
- 反映和规定必须遵守的,基本的通用的完整性约束条件
- 提供定义完整性约束条件的机制,以反映具体应用锁设计的数据必须遵守的特定的语义约束条件
1.2.4 常用的数据模型
- 层次模型
- 网状模型
- 关系模型
- 面向对象数据模型
- 对象关系数据模型
- 半结构化数据模型
(后面三种是创新前沿,作为基础课,后续只讲前三种数据模型)
1.2.5 层次模型
层次模型用树形结构来表示各类实体以及实体间的联系。
层次模型是数据库中最早出现的模型。
优点:
- 层次模型的数据结构比较简单清晰
- 查询效率高,性能优于关系模型,不低于网状模型
- 层次数据模型提供了良好的完整性支持
缺点:
- 节点之间的多对多联系表示不自然
- 对插入和删除操作的限制多,应用程序的编写比较复杂
- 查询子女节点必须通过双亲节点
- 层次命令趋于程序化
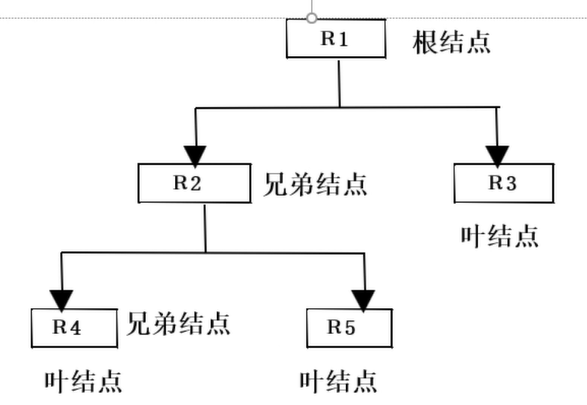
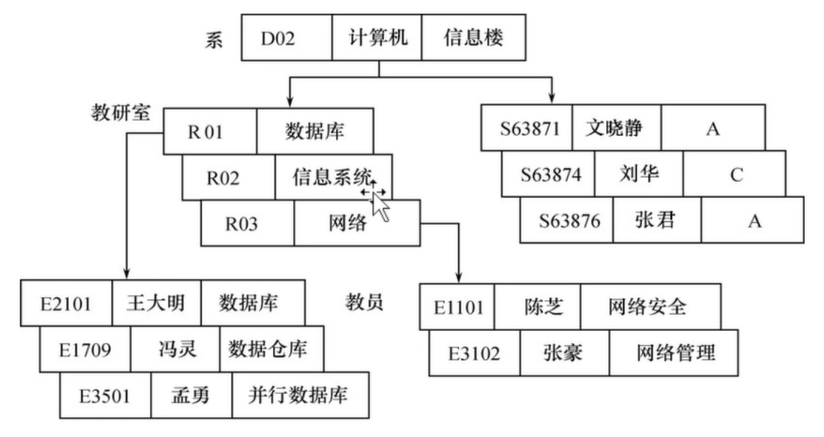
1.2.6 网状模型
和层次模型的区别:网状模型中子女节点与双亲节点的联系可以不唯一
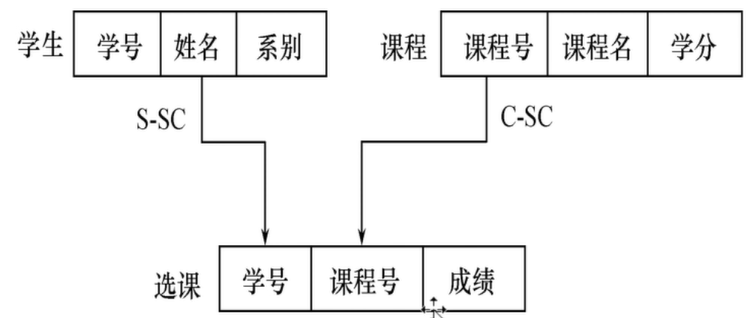
1.2.7 关系模型
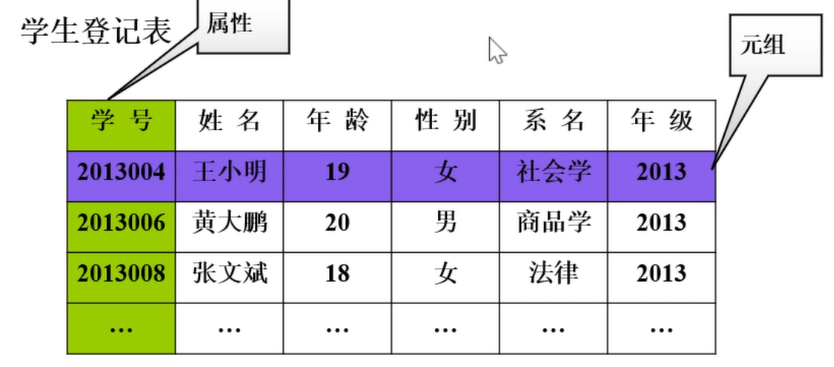
在用户观点下,关系模型中数据的逻辑结构是一张二维表,它由行和列组成。
关系模型的数据结构:
- 关系(Relation):一个关系对应通常说的一张表
- 元组(Tuple):表中的一行即为一个元组
- 属性(Attribute):表中的一列即为一个属性,给每一个属性起一个名字叫属性名
- 键(Key):也称码键。表中的某个属性组,它可以唯一地确定一个元组
- 域(Domain):是一组具有相同数据类型的值的集合。属性的取值范围来自某个域
- 关系模式:对关系的描述——关系名(属性1,属性2,······,属性n)。不允许表中还有表
关系模型的操作: 数据操作是集合操作,操作对象和操作结果都是关系。 仍然包括增删改查
关系的完整性约束条件: 实体完整性,参照完整性,用户定义的完整性
优点:
- 建立在严格的数据概念的基础上
- 概念单一:实体和格力联系都用关系来表示,对数据的检索结果也是关系
- 关系模型的存取路径对用户透明:具有更高的数据独立性,更好的安全保密性,并且简化了程序员的工作
缺点:
- 存取路径对用户透明,查询效率往往不如格式化数据模型
- 为提高性能,必须对用户的查询请求进行优化,增加了开发数据库管理系统的难度

1.3 数据库系统的结构
从用户角度看,数据库系统应用结构:
- 单用户结构
- 集中式结构
- 分布式结构
- 客户/服务器结构
1.3.1 数据库系统模式的概念
“型”和“值”的概念: 型是框架,值是某一刻的照片
- 型(Type):对某一类数据的结构和属性的说明
- 值(Value):是型的一个具体赋值
模式和实例: 同型和值
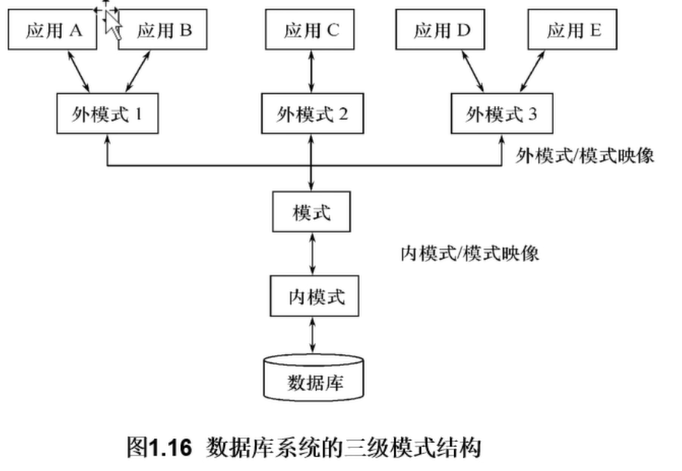
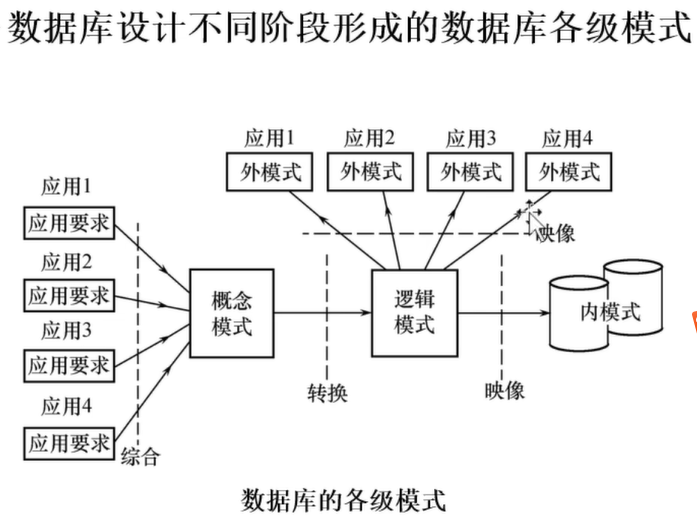
1.3.2 数据库系统的三级模式结构
1.3.3 数据库的两层映像功能与数据独立性
一个数据库只有一个模式。
外模式: 从模式中选取和应用有关的部分,映射成对应的外模式
内模式: 处理表如何变成0和1映射到硬件上
优点:
- 模式能保证安全性,并不会一个损坏全部损坏
- 映像能保证各干各的
1.4 数据库系统的组成
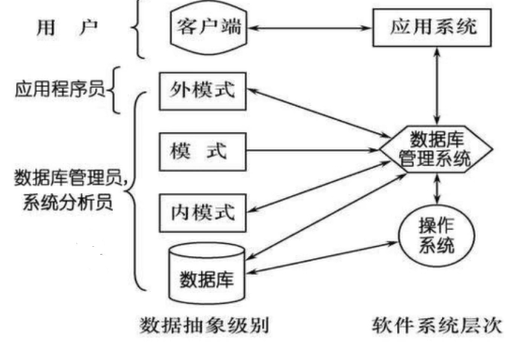
- 数据库
- 数据库管理系统
- 应用程序
- 数据库管理员
1.5 小结
数据库系统概述
- 数据库的基本概念
- 数据管理的发展过程
- 数据库系统的特点
数据模型
- 数据模型的三要素
- 三种主要数据模型
数据库系统内部的系统结构
- 三层模式
- 两层映像
数据库系统的组成
- 数据库
- 数据库管理系统
- 应用程序
- 数据库管理员
二、关系数据库
2.1 关系数据结构及形式化定义
2.1.1 关系
为什么在数据库这门课,可以说关系=二维表?
为回答这个问题,接下来要介绍几个概念:
-
域: 域是一组具有相同数据类型的值的集合,用于表示取值的范围
-
笛卡尔积: 所有域的所有取值组合的可能性,D1xD2x ... xDn = { (d1,d2, ... ,dn) | di ∈Di , i=1,2,...,n}
笛卡尔积中每一个元素 (d1,d2, ... ,dn) 叫作一个n元组或简称元组
笛卡尔积元素 (d1,d2, ... ,dn) 中的每一个值 di 叫作分量
基数:表示笛卡尔积有多少种可能性笛卡尔积可以用二维表表示,表中每行对应一个元组,每列对应一个域。
不同属性的取值可以来自于同一个域 -
关系:D1xD2x ... xDn 的子集叫作在域 D1,D2, ... ,Dn 上的关系,表示为 R(D1,D2, ... ,Dn)
R:关系名
n:关系的目或度(Degree)
键:可以是多个属性的组合(例如学号+课程名)
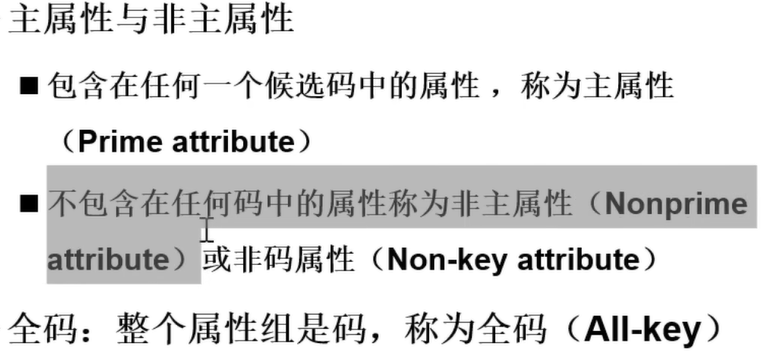
- 候选码(Candidate key):关系中的某一属性组的值,能唯一地标识一个元组,则称该属性组为候选码。候选码包含的属性叫作主属性列,不包含在任何候选码中的属性叫作非主属性列。最简单的情况:候选码只包含一个属性。
- 全键(All-key):最极端的情况——关系模式的所有属性组合在一起才是这个关系模式的候选码,称为全键
- 主键(Primary key):若一个关系有多个候选码,则选定其中一个为主键
三类关系:
- 基本关系(基本表或基表):实际存在的表,是实际存储数据的逻辑表示
- 查询表:查询结果对应的表
- 视图表:由基本表或其他视图表映射出来的表,是虚表,不对应实际存储的数据
基本关系的性质:
- 列是同质的(Homogeneous)
- 不同的列可出自同一个域,其中每一列称为一个属性
- 列的顺序无所谓,可以任意交换
- 行的顺序无所谓,可以任意交换
- 任意两个元组的候选码不能相同
- 分量必须取原子值(表中不能有表)
2.1.2 关系模式
关系模式:二维表的框架(关系=二维表,模式=框架)
关系模式是型,关系是值,关系模式是对关系的描述
为什么要制定关系模式? 答:统一对关系的描述,方便不同的数据库管理软件处理。
定义关系模式从五个方面入手:关系模式可以形式化地表示为 R( U, D, DOM, F)
- R:关系名
- U:组成该关系的属性名集合
- D:U中属性所来自的域
- DOM:属性向域的映像集合
- F:属性间数据的依赖关系的集合(比如非主属性对主属性是依赖的)
关系模式与关系:
- 关系模式是静态的、稳定的,是对关系的描述
- 关系是动态的、随时间不断变化的,是关系模式在某一时刻的状态或内容
2.1.3 关系数据库
以二维表为基础数据结构的数据库就叫作关系数据库
关系数据库的型与值:
- 关系数据库的型:关系数据库模式,是对关系数据库的描述
- 关系数据库的值:关系模式在某一时刻对应的关系的集合,通常称为关系数据库
2.1.4 关系模型的存储结构
关系数据库的物理组织(不太重要):
- 将物理数据组织交给操作系统完成
- 向操作系统申请若干个文件,自己进行管理
2.2 关系操作
2.2.1 基本的关系操作
关系运算分为两大类:
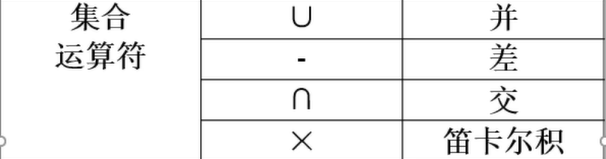
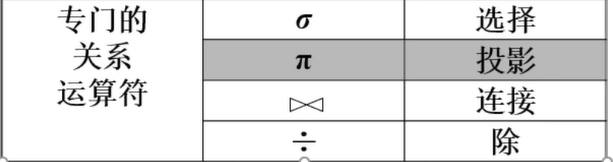
- 关系运算:选择、投影、连接、除
- 集合运算:并、差、交、笛卡尔积
2.2.2 关系数据库语言的分类
-
关系代数语言:用对关系的运算来表达查询要求,代表ISBL
-
关系演算语言:用谓词来表达查询要求
元组关系演算:谓词变元的基本对象是元组变量,代表APLHA/QUEL
域关系演算语言:谓词变元的基本对象是域变量,代表QBE
-
同时具有关系代数和关系演算双重特点的语言:代表SQL
2.3 关系的完整性
关系的完整性:表的约束条件(关系=表,完整性=约束条件)
关系的三类约束条件:最开始我们有提到,我们想做的是将现实世界里的东西映射到计算机里。那现实世界里有三个东西——实体、属性、联系,三类约束条件对应的就是这三个东西。
- 实体完整性:对实体的约束
- 参照完整性:对联系的约束
- 用户定义的完整性:对属性的约束
2.3.1 实体完整性
实体完整性的规则: 若属性A是基本关系R的主属性,则属性A不能取空值。简单来说就是:主属性不能取空值
空值就是“不知道”或“不存在”或“无意义”的值
2.3.2 参照完整性
关系间的引用:外键连主键。 可以是两个表直接连,也可以是自己连自己
外键:设F是基本关系R的一个或一组属性,但不是关系R的主键。如果F与基本关系S的主键KS相对应,则称F是R的外键。基本关系R称为参照关系,基本关系S称为目标关系。
注意:
- 关系R和S不一定是不同的关系
- 目标关系S的主键KS和参照关系的外键F必须定义在同一个(或同一组)域上
- 外键并不一定要与相应的主键同名(当然最好是同名,方便识别)
参照完整性的规则: 若属性F是基本关系R的外键,它与基本关系S的主键KS相对应,则对于R中每个元组在F上的值必须为:
- 或者取空值(F的每个属性值均为空值)
- 或者等于S中某个元组的主键值(与另一个表的主键对应)
2.3.3 用户定义的完整性
用户定义完整性的规则: 是指用户根据具体业务规则对数据处理规则要求所定义的数据约束,比如定义列的数据类型与取值范围,定义列的缺省值,定义列是否非空,是否唯一,列之间是否有数据依赖性
通常用来约束属性。自己按照需求规定。
2.4 关系代数
关系代数是一种抽象的查询语言,它用对关系的运算来表达查询
关系代数的运算符有两类:
- 集合运算符
![image]()
- 专门的关系运算符
![image]()
2.4.1 集合运算符
1.并
RUS = { t | t ∈ R v t ∈S}
属于R或S的所有元组组成
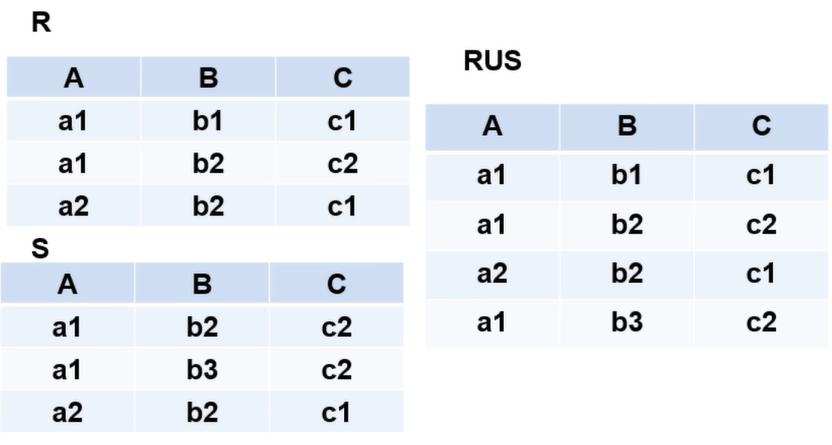
前提条件:
- 具有相同的目n (即两个关系都有n个属性,列数必须相同)
- 相应的属性取自同一个域(即列必须一一对应)
2.差
R-S = { t | t ∈ R ∧ t ∉ S}
属于R而不属于S的所有元组组成

前提条件:
- 具有相同的目n (即两个关系都有n个属性,列数必须相同)
- 相应的属性取自同一个域(即列必须一一对应)
3.交
R∩S = { t | t ∈ R ∧ t ∈ S} = R-(R-S)
既属于R又属于S的所有元组组成
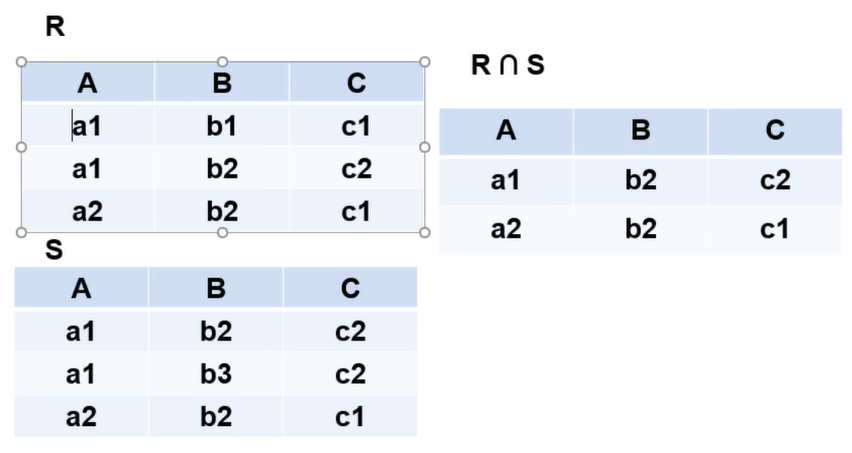
前提条件:
- 具有相同的目n (即两个关系都有n个属性,列数必须相同)
- 相应的属性取自同一个域(即列必须一一对应)
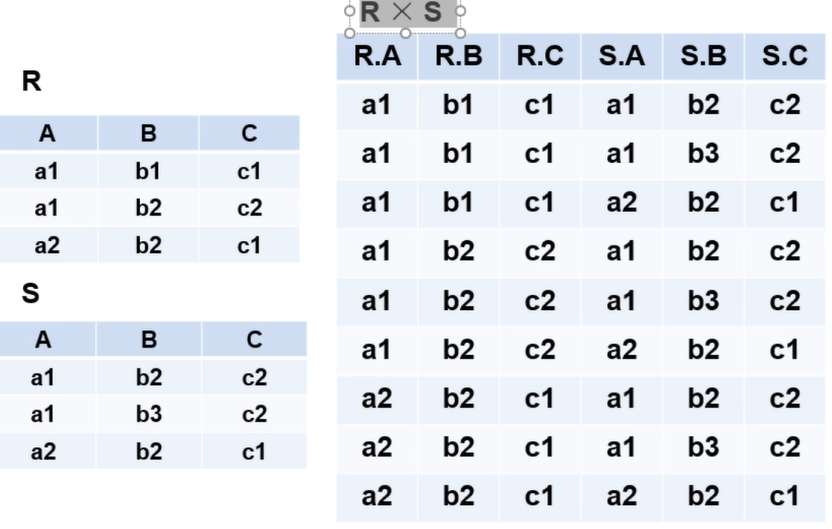
4.笛卡尔积
RxS:R有n目关系,k1个元组;S有m目关系,k2个元组;
-
列:(n+m)列元组的集合
元组的前n列是关系R的一个元组,后m列是关系S的一个元组
-
行:k1xk2个元组
![image]()
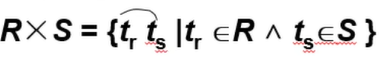
表示R和S组合的所有可能性。列是相加,行是相乘
2.4.2 关系运算
先引入几个记号:
- R:关系R
- t ∈ R:t是R的一个元组
- t[Ai]:元组 t 中对应于属性Ai的一个分量
- A:属性组A或属性列A
- t[A]:元组t在属性列A上各个分量的集合
-
![image]() :表示去除掉A列之后的列
-
![image]() :表示元组的连接,tr ∈ R,ts ∈ S
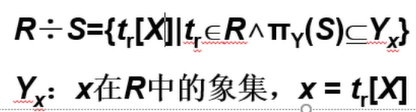
- 象集Zx:表示R中属性组X中值为x的各个元组在Z上分量的集合
Zx =
 :表示去除掉A列之后的列
 :表示元组的连接,tr ∈ R,ts ∈ S
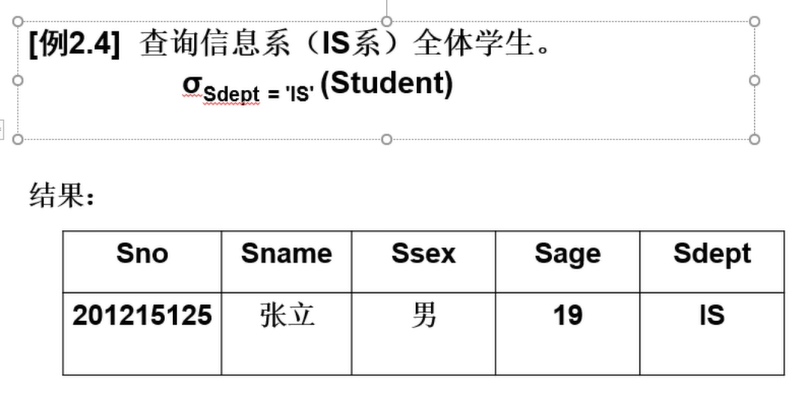
1.选择
选择又称为限制。
选择运算符的含义: 在关系R中选择满足给定条件的元组。是从行的角度进行运算
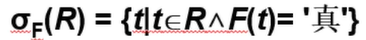
F: 选择条件,是一个逻辑表达式,取值为“真”或“假”
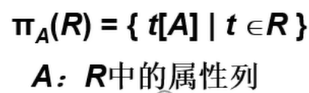
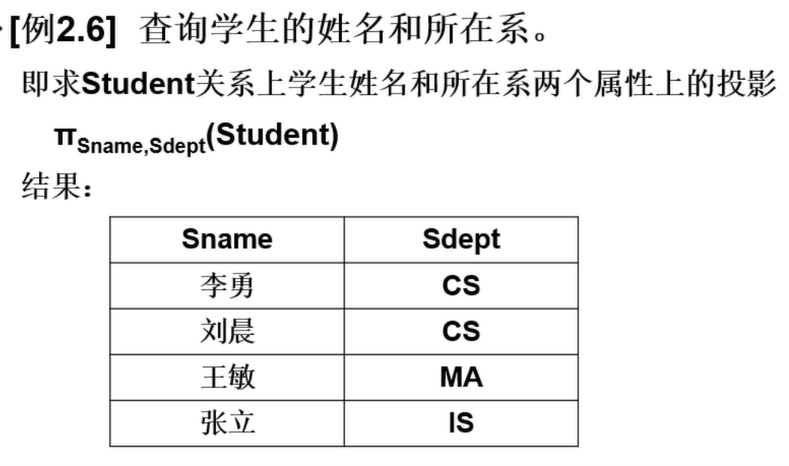
2.投影
投影的含义: 从R中选择出若干属性列组成新的关系。是从列的角度进行运算
3.连接(join)
连接运算的含义:先作RxS的笛卡尔积,再从笛卡尔积中筛选满足条件的行
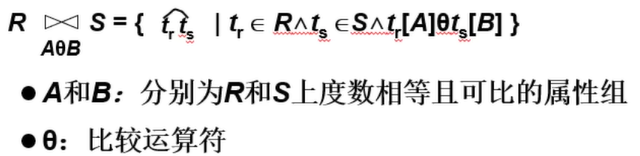
两类常用连接运算:
- 等值连接(equi-join)
θ为“=”的连接运算称为等值连接 - 自然连接(natural-join)
自然连接时一种特殊的等值连接:在结果中把重复的属性列去掉
悬浮元组(Dangling tuple): 两个关系R和S在做自然连接时,关系R中某些元组有可能在S中不存在公共属性上值相等的元组,从而造成R中这些元组在操作时被舍弃了,这些被舍弃的元组称为悬浮元组。
外连接(Outer join): 如果把悬浮元组也保存在结果关系中,而在其他属性上填空值(Null),就叫做外连接
左外连接:只保留左边关系R中的悬浮元组;右外连接:只保留右边关系S中的悬浮元组
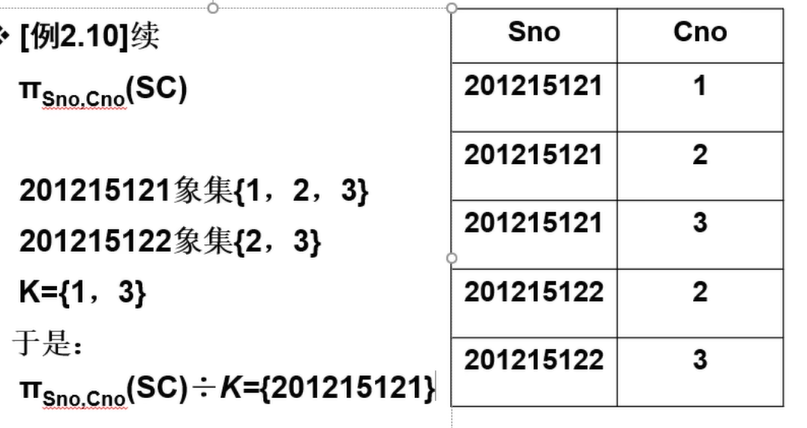
4.除运算
除运算:常用于表示“包含”
2.6 小结
关系数据库系统是目前使用最广泛的数据库系统。
关系数据结构:
-
关系
域,笛卡尔积,关系
关系运算:选择、投影、连接、除;集合运算:并、交、差、笛卡尔积 -
关系模式
-
关系数据库
-
关系模型的存储结构
完整性约束条件:
- 实体完整性
- 参照完整性
- 用户定义的完整性
关系代数做题思路:
- 输入
- 输出
- 范围
- 筛选条件
三、SQL
3.1 SQL概述
SQL(Structured Query Language): 结构化查询语言,是关系数据库的标准语言。
SQL是一个通用的、功能极强的关系数据库语言
3.1.1 SQL的产生与发展
SQL标准的进展过程:
| 标准 | 大致页数 | 发布日期 |
|---|---|---|
| SQL/86 | 1986.10 | |
| SQL/89(FIPS 127-1) | 120页 | 1989年 |
| SQL/92 | 622页 | 1992年 |
| SQL99(SQL 3) | 1700页 | 1999年 |
| SQL2003 | 3600页 | 2003年 |
| SQL2008 | 3777页 | 2006年 |
| SQL2011 | 2010年 |
3.1.2 SQL的特点
-
综合统一:
集DDL、DML、DCL功能于一体
可以独立完成数据库生命周期中的全部活动:增删改查数据库;对数据库进行重构和维护;完成数据库安全性、完整性控制等 -
高度非过程化:
SQL只要提出“做什么”,无须了解存取路径
-
面向集合的操作方式:
操作对象,增删改查的结果可以是元组的集合
-
以同一种语法结构提供多种使用方式:
SQL既可以是独立的语言,也可以嵌入到高级语言中(例如C, C++, Java)
-
语言简洁,易学易用:
SQL功能 动词 数据查询 Select 数据定义 Create, drop, alter 数据操纵 Insert, update, delete 数据控制 grant, revoke
3.1.3 SQL的基本概念
SQL可以处理视图,基本表,和上层应用

基本表:
- 本身独立的表
- SQL中一个关系就对应一个基本表
- 一个(或多个)基本表对应一个存储文件
- 一个表可以带若干索引
存储文件:
- 逻辑结构组成了关系数据库的内模式
- 物理结构是对用户是屏蔽的
视图(view):
- 从一个或者几个基本表导出的表
- 数据库中只存放视图的定义而不存放视图对应的数据
- 视图是一个虚表。数据在基本表里
- 用户可以在视图上再定义视图
3.2 学生-课程数据库
学生课程模式 S-T:
- 学生表:Student(Sno, Sname, Ssex, Sage, Sdept)
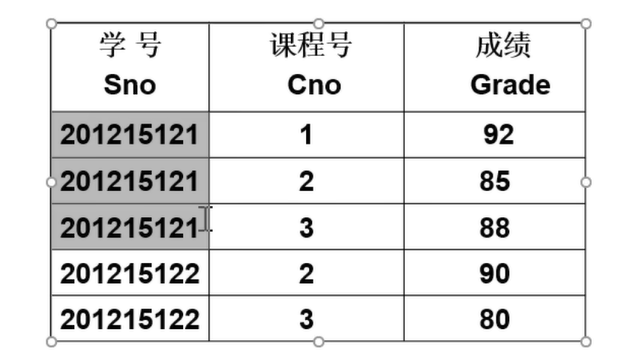
- 课程表:Course(Cno, Cname, Cpno, Ccredit)
- 学生选课表:SC(Sno, Cno, Grade)
Student(Sno, Sname, Ssex, Sage, Sdept):主键Sno
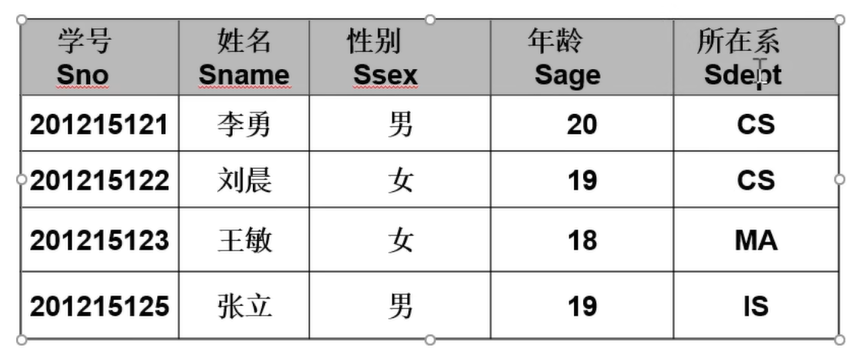
Course(Cno, Cname, Cpno, Ccredit):主键Cno,外键Cpno

SC(Sno, Cno, Grade):主键Sno,Cno
3.3 数据定义
SQL的数据定义功能:
- 模式定义
- 表定义
- 视图和索引的定义
SQL的数据定义语句:
| 操作对象 | 创建 | 删除 | 修改 |
|---|---|---|---|
| 模式 | create schema | drop schema | |
| 表 | create table | drop table | alter table |
| 视图 | create view | drop view | |
| 索引 | create index | drop index | alter index |
模式(模式=数据库schema)相当于是地基,所以一般不会去修改;视图是虚表,比起修改,不如直接删掉重建
3.3.1 模式的定义与删除
1.定义模式
定义模式实际上定义了一个命名空间。在这个空间中,可以定义该模式包含的数据库对象,例如基本表、视图、索引等
官方写法为:
Create schema <模式名> authorization <用户名>[<表定义子句>|<视图定义子句>|<授权定义子句>]
例1:为用户Wang定义一个学生-课程模式"S-T"
Create schema "S-T" authorization Wang;
Create schema authorization Wang;	/*没有<模式名>的话,<模式名>默认为<用户名>*/
例2:为用户Zhang定义一个模式"TEST",并且在其中定义一个表Tab1
create schema TEST authorization Zhang
create table Tab1 (col1 smallint, col2 int, col3 char(20), col4 numeric(10,3), col5 decimal(5,2) );
2.删除模式
官方写法:
drop schema <模式名> <cascade|restrict>
/*
cascade(级联删除):删除模式的同时把该模式中所有的数据库对象全部删除
restrict(限制删除):如果该模式中定义了下属的数据库对象(如表、视图等),则拒绝该删除语句的执行。只有该模式中没有任何下属对象时才能执行
*/
例:级联删除模式"Zhang"
drop schema Zhang cascade
3.3.2 基本表的定义与删除
1.定义基本表
官方写法:
create table <表名>
(
<列名> <数据类型> [<列级完整性约束条件>],
<列名> <数据类型> [<列级完整性约束条件>],
......
[<表级完整性约束条件,主键外键>]
);
例1:建立学生表"Student"
create table Student
(
Sno char(9) PRIMARY KEY,	/*列级完整性约束条件,Sno是主键*/
Sname char(20) UNIQUE,	/*列级完整性约束条件,Sname取唯一值*/
Ssex char(2),
Sage smallint,
Sdept char(20)
);
例2:建立课程表"Course"
create table Course
(
Cno char(4) PRIMARY KEY,	/*列级完整性约束条件,Cno是主键*/
Cname char(40) UNIQUE,	/*列级完整性约束条件,Cname取唯一值*/
Cpno char(4),
Ccredit smallint,
foreign key (Cpno) References Course(Cno)
);
例3:建立"SC"表
create table SC
(
Sno char(9),
Cno char(4),
Grade smallint,
PRIMARY KEY (Sno,Cno),
foreign key (Cno) References Course(Cno),
foreign key (Sno) References Student(Sno)
);
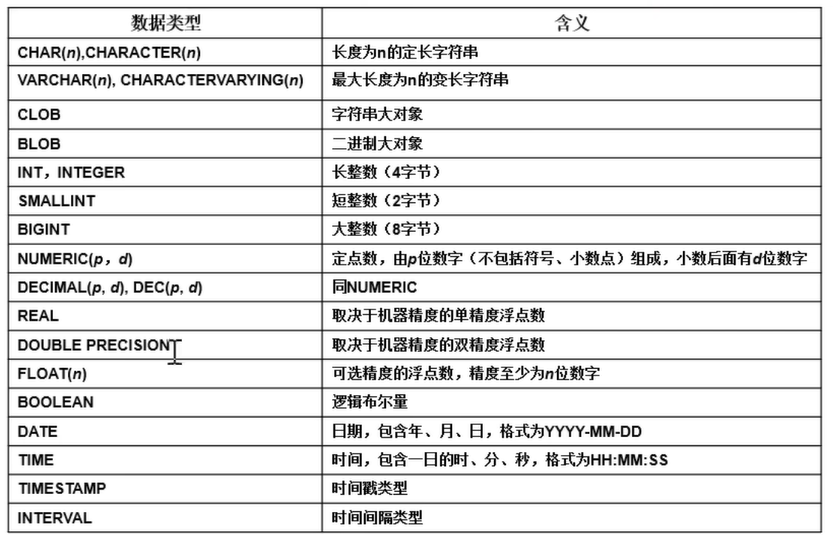
2.数据类型
3.模式与表
每一个基本表都属于某一个模式,一个模式可以包含多个基本表。
定义基本表所属模式:
/* 法一:在表名中明显地给出模式 */
Create table "S-T".Student(......);	/*模式名为S-T*/

/* 法二:在创建模式语句中同时创建表 */
create schema TEST authorization Zhang
create table Tab1 (col1 smallint, col2 int, col3 char(20), col4 numeric(10,3), col5 decimal(5,2) );

/* 法三:设置所属模式 */
SET search_path TO "S-T",public;
Create table Student(...);
4.修改基本表
官方写法:
alter table <表名>
	[add[column] <新列名> <数据类型> [完整性约束]]	/* 用于新增列,包括列名,数据类型,列级完整性约束条件。不管原本表中是否有数据,新增的列一律为空值 */
	[add <列级完整性约束>(<列名>)]	/* 用于新增列级完整性约束条件 */
	[add <表级完整性约束>]	/* 用于新增表级完整性约束条件 */
	[drop [column] <列名> [cascade|restrict] ]	/* 用于删除表中的列 */
	[drop constraint <完整性约束名> [cascade|restrict] ]	/* 用于删除指定的完整性约束条件 */
	[alter column <列名> <数据类型>];	/* 用于修改原有列的定义,包括修改列名和数据类型 */
例1:向Student表增加“入学时间”列,其数据类型为日期型。
alter table Student add S_entrance DATE;
例2:将年龄的数据类型由字符型改为整数
alter table Student alter column Sage int;
例3:增加课程名称必须取唯一值的约束条件
alter table Course add unique(Cname);
5.删除基本表
官方写法:
drop table <表名> [cascade|restrict]
列:删除Student表
drop table Student cascade
3.3.3 索引的定义与删除
1.简介
建立索引的目的: 加快查询速度
关系数据库管理系统中常见索引:
- 顺序文件上的索引
- B+树索引:具有动态平衡的优点
- hash索引:具有查找速度快的优点
- 位图索引
对索引的处理权限:
-
谁可以建立索引:
数据库管理员或表的属主(即建立表的人)
-
谁维护索引:
关系数据库管理系统自动完成
-
谁能使用索引:
都能用。但用户不能也不必显示地选择索引,关系数据库管理系统会自动选择合适的索引作为存取路径
2.建立索引
官方写法:
create [UNIQUE] [CLUSTER] index <索引名> on <表名>(<列名>[<次序>],...);
/*
索引可以建立在该表的一列或多列上,列名之间用逗号分隔。
<次序>:指定索引值的排列次序。ASC:升序;DESC:降序;不写默认为升序ASC
UNIQUE:此索引的每一个索引值只对应唯一的数据记录
CLUSTER:表示要建立的索引是聚簇索引
*/
例:为学生-数据库数据库中的Student, Course, SC三个表建立索引。Student表按学号升序建唯一索引,Course表按课程号升序建唯一索引。
create unique index Stusno ON Student(Sno);
create unique index Coucno ON Course(Cno);
create unique index SCno ON SC(Sno ASC, Cno DESC);
3.修改索引
官方写法:
alter index <旧索引名> rename to <新索引名>;
例:将SC表的SCno索引名改为SCSno
alter index SCno rename to SCSno;
4.删除索引
官方写法:
drop index <索引名>;
例:删除Student表的Stusname索引
drop index Stusname;
3.3.4 数据字典
给别人看,方便让别人知道你的表们、数据们是什么意思。
数据字典是关系数据库管理系统内部的一组系统表,它记录了数据库中所有定义信息,包括:
- 关系模式定义
- 视图定义
- 索引定义
- 完整性约束定义
- 各类用户对数据库的操作权限
- 统计信息等
3.4 数据查询
官方写法:
select [all|distinct] <目标列表达式>[,<目标列表达式>,...]
from <表名或视图名>[,<表名或视图名>,...] | (select 语句)
	[as] <别名>
[where <条件表达式>]
[group by <列名1> [having <条件表达式>] ]	/* having=where,只是group by时只能用having表示限制条件 */
[order by <列名2> [asc|desc] ];
/*
[all|distinct]:默认为all。dinstinct的作用是去除取值重复的行
group by:对查询结果表,按指定列的值分组,该属性列值相等的元组为一组
order by:对查询结果表,按指定列值的升序或降序排序
*/
3.4.1 单表查询
查询仅涉及一个表
1.选择表中的若干列(select详解)
例1:查询全体学生的学号与姓名
select Sno,Sname
from Student;
例2:查询全体学生的详细记录
select *
from Student;
/* 当<目标列表达式>指定为'*'时,表示全体 */
例3:查询全体学生的姓名及其出生年份
select Sname,2024-Sage
from Student;
/* select子句的<目标列表达式>不仅可以为表中的属性列,也可以是表达式,也可以是函数 */
例4:查询全体学生的姓名、出生年份和所在院系,要求用小写字母表示系名
select Sname, 'Year of Birth', 2024-Sage, LOWER(Sdept)
from Student;
/* 编程语言中,一般没引号的表示变量,有引号的表示常量 */
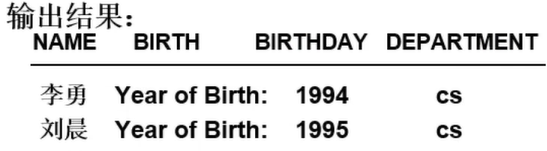
例5:使用列别名改变查询结果的列标题
select Sname NAME,'Year of Birth' BIRTH, 2014-Sage BIRTHDAY, LOWER(Sdept) DEPARTMENT
from Student;
2.选择表中的若干元组(where详解)
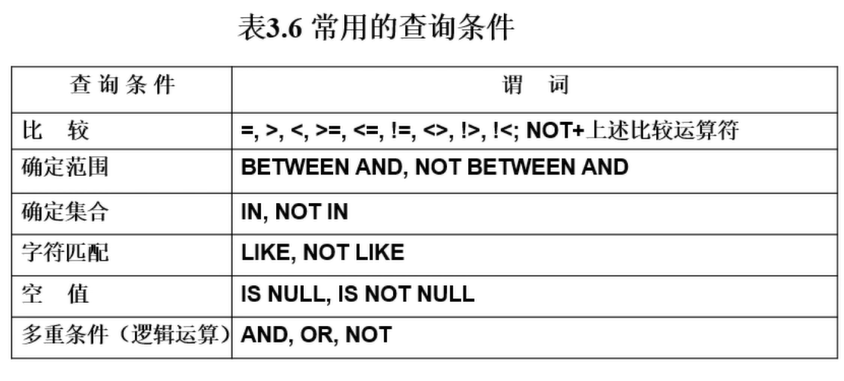
①比较大小:=/</>
例1.1:查询计算机系全体学生的名单
select Sname
from Student
where Sdept='CS';
例1.2:查询所有年龄在20岁以下的学生姓名及年龄
select Sname,Sage
from Student
where Sage<20;
例1.3:查询考试成绩有不及格的学生的学号
select distinct Sno
from SC
where Grade<60;
②确定范围:between and
例2.1:查询年龄在20-23岁之间的学生的姓名、系别和年龄
select Sname,Sdept,Sage
from Student
where Sage BETWEEN 20 and 23;
例2.2:查询年龄不在20-23岁之间的学生的姓名、系别和年龄
select Sname,Sdept,Sage
from Student
where Sage NOT BETWEEN 20 and 23;
③确定集合:in()
例3.1:查询计算机系(CS),数学系(MA)学生的姓名和性别
select Sname,Ssex
from Student
where Sdept in ('CS','MA');
例3.2:查询既不是计算机系(CS),也不是数学系(MA)学生的姓名和性别
select Sname,Ssex
from Student
where Sdept not in ('CS','MA');
④字符匹配:like
可以包含有通配符'%'和'':'%'代表任意长度(可以为0)的字符串,''代表任意单个字符
例4.1:查询学号为201215121学生的详细情况
select *
from Student
where Sno LIKE '201215121';
例4.2:查询所有姓“刘”的同学的姓名、学号、性别
select Sname,Sno,Ssex
from Student
where Sname LIKE '刘%';
例4.3:查询所有姓“欧阳”且全名为三个汉字的同学的姓名
select Sname
from Student
where Sname LIKE '欧阳_';
例4.4:查询所有不姓“刘”的同学的姓名、学号、性别
select Sname,Sno,Ssex
from Student
where Sname not LIKE '刘%';
例4.5:查询DB_Design课程的课程号和学分。(涉及转义字符)
select Cno,Ccredit
from Course
where Cname like 'DB\_Design' ESCAPE'\';
/*
ESCAPE'\' :表示'\'为转义字符
*/
⑤涉及空值的查询:is null
注意: 'is' 不能用 '=' 来代替
例5.1:查询选课但缺少考试成绩的学生的学号
select Sno
from SC
where Grade is null;
⑥多重条件查询:and/or
注意: and的优先级高于or,但可以用括号来改变优先级
例6.1:查询计算机系年龄在20以下的学生姓名
select Sname
from Student
where Sdept='CS' and Sage<20;
3.order by子句
默认为ASC。
对于空值,排序时显示的次序由具体系统实现来决定。(一个通用规律:空值跟大头)
例1:查询选修了3号课程学生的学号及成绩,查询结果按分数降序排序
select Sno,Grade
from SC
where Cno='3'
order by Grade DESC;
例2:查询全体学生的详细情况,按所在系的系号升序排列,同一系中的学生按年龄降序排列
select *
from Student
order by Sdept, Sage DESC;
4.聚集函数
- 统计元组个数:
count(*) - 统计一列中值的个数:
count([all|distinct] <列名>) - 计算一列值的总和:
SUM([all|distinct] <列名>) - 计算一列值的平均值:
AVG([all|distinct] <列名>) - 求一列值的最大值和最小值:
MAX([all|distinct] <列名>) ;MIN([all|distinct] <列名>)
例1:查询学生的总人数
select count(*)
from Student;
例2:查询选修了课程的学生人数
select count(distinct Sno)
from SC;
例3:计算1号课程的学生评价成绩
select AVG(Grade)
from SC
where Cno='1';
例4:查询1号课程的学生的最高分数
select MAX(Grade)
from SC
where Cno='1';
例5:查询学生201215012选修课程的总学分
select SUM(Ccredit)
from SC,Course
where Sno='201215012' and SC.Cno=Course.Cno;
5.group by子句
group by子句分组的作用:精细化聚集函数的操作对象。如果未对查询结果进行分组,聚集函数将作用域整个查询结果;对查询结果进行分组后,聚集函数将分别作用于每个组。
having子句和where子句的区别: having短语作用于组,where子句作用于基表或视图
例1:查询选修了3门以上课程的学生学号
select Sno
from SC
group by Sno
Having count(*)>3;
/*
注意:group by一定是配合having的
*/
例2:查询评价成绩大于等于90分的学生学号和平均成绩
select Sno,AVG(Grade)
from SC
group by Sno
having AVG(Grade)>=90
3.4.2 连接查询
连接查询一定有连接条件,因为不加筛选是笛卡尔积,即所有可能性。
所以连接查询时,先写连接条件,再写题目中需要的筛选条件。
连接查询有笛卡尔积,查询效率稍稍低一点。
连接操作的执行过程:
- 循环嵌套法
- 排序合并法
- 索引连接
1.等值与非等值连接查询
等值连接: 连接运算符为'='
例1:查询每个学生及其选修课程的情况
select Student.*,SC.*
from Student,SC
where Student.Sno = SC.Sno;
自然连接:去掉重复列
例2:对例1用自然连接完成
select Student.Sno,Sname,Ssex,Sage,Sdept,Cno,Grade
from Student,SC
where Student.Sno = SC.Sno;
例3:查询选修2号课程且成绩在90分以上的所有学生的学号和姓名。
select Student.Sno, Sname
from Student,SC
where Student.Sno = SC.Sno
	  and SC.Cno='2' and SC.Grade>90;
2.自身连接
自身链接: 资格标与自己进行连接。
需要给表起别名以示区别。由于所有属性名都是同名属性,因此必须使用别名前缀。
例:查询每一门课的间接先修课(即先修课的先修课)
select FIRST.Cno,SECOND.Cpno
from Course FIRST,Course SECOND
where FIRST.Cpno = SECOND.Cno;
3.外连接
外连接与普通连接的区别:普通连接操作只输出满足连接条件的元组。外连接操作以指定表为连接主体,将主体表中不满足连接条件的元组一并输出
例:查询每个学生及其选修课程的情况。用外连接完成
select Student.Sno,Sname,Ssex,Sage,Sdept,Cno,Grade
from Student LEFT OUT JOIN SC ON
	(Student.Sno=SC.Sno);
4.多表连接
多表连接:两个以上的表进行连接
例1:查询每个学生的学号、姓名、选修课的课程名及成绩
select Student.Sno,Sname,Cname,Grade
from Student, SC, Course
where Student.Sno = SC.Sno
	and SC.Cno = Course.Cno;
3.4.3 嵌套查询
嵌套查询: 一个select-from-where语句称为一个查询块。将一个查询块嵌套在另一个查询块的where子句或者having语句的条件中的查询,称为嵌套查询。
外层查询叫父查询,内层查询叫子查询。SQL语句允许多层嵌套查询,但是子查询不能使用order by
嵌套查询求解方法:
-
不相关子查询:子查询的查询条件不依赖父查询
由内向外,逐层处理。即每个子查询在上一层查询处理之前求解。子查询的结果用于建立父查询的查询条件
-
相关子查询:子查询的查询条件依赖父查询
首先取外层查询中表的第一个元组,根据它与内层查询相关的属性值处理内层查询,若where子句返回值为真,则取此元组放入结果表
然后再取外层表的下一个元组。重复这一过程,直到外层表全部检查完为止
1.带有IN谓词的子查询
例1:查询与“刘晨”在同一个系学习的学生
/* ①查找'刘晨'所在系 */
select Sdept
from Student
where Sname='刘晨';	/* 输出'CS' */

/* ②查找CS系的学生 */
select Sno,Sname,Sdept
from Student
where Sdept='CS';

/* ③组合:将第一步查询嵌入第二部查询条件中 */
select Sno,Sname,Sdept
from Student
where Sdept IN
	(select Sdept
	from Student
	where Sname='刘晨');
例2:查询选修了课程名为“信息系统”的学生学号和姓名
select Sno,Sname from Student where Sno IN
	(select Sno from SC where Cno IN
		(select Cno from Course where Cname='信息系统'));
2.带有比较运算符的子查询
例1:查询与“刘晨”在同一个系学习的学生
select Sno,Sname,Sdept
from Student
where Sdept =
	(select Sdept
	from Student
	where Sname='刘晨');
例2:找出每个同学超过他选修课平均成绩的课程号
select Sno,Cno
from SC x
where Grade>= (select AVG(Grade)
				from SC y
				where y.Sno=x.Sno);
3.带有ANY或ALL谓词的子查询

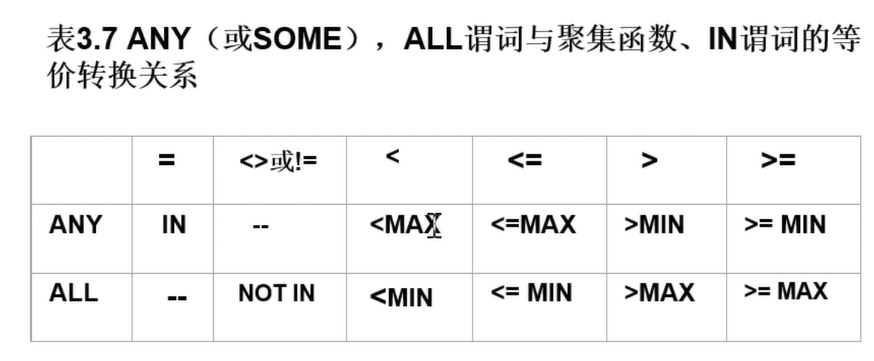
例:查询非计算机科学系中比计算机科学系任意一个学生年龄小的学生姓名和年龄
select Sname, Sage
from Student
where Sage < ANY(select Sage from Student where Sdept='CS')
	and Sdept <> 'CS';

/* 也可以这样写: */
select Sname, Sage
from Student
where Sage < (select MAX(Sage) from Student where Sdept='CS')
	and Sdept <> 'CS';
4.带有EXISTS谓词的子查询
EXISTS谓词:存在谓词。带有EXISTS谓词的子查询不返回任何数据,只产生逻辑真值“true”或逻辑假值“false”。因为“不返回任何数据”,所以EXISTS的子查询通常跟着select *
例:查询所有选修了1号课程的学生姓名
select Sname
from Student
where EXISTS
	(select *
	from SC
	where Sno = Student.Sno AND Cno='1');
3.4.4 集合查询
union:并集,查询后去除重复项
union all:不去除重复项
例1:查询计算机科学系的学生及年龄不大于19岁的学生。
select * from Student where Sdept='CS'
union select * from Student where Sage<=19;
intersect:交集
例2:查询计算机科学系的学生与年龄不大于19岁的学生的交集。
select * from Student where Sdept='CS'
intersect select * from Student where Sage<=19;
3.4.5 基于派生表的查询
派生表: 基于基本表进行的一些运算结果(例如求平均值),在实际操作中发现这些结果也经常使用,即可以将他们存放在派生表里,方便使用。
例1:找出每个同学超过他选修课平均成绩的课程号
select Sno,Cno
from SC,(select Sno,Avg(Grade)
		from SC group by SNO) as Avg_sc(avg_sno,avg_grade)
where SC.Sno = Avg_sc.avg_sno and SC.Grade >= Avg_sc.avg_grade;
3.4.6 select语句的总结
select [all|distinct] <目标列表达式>[,<目标列表达式>,...]
from <表名或视图名>[,<表名或视图名>,...] | (select 语句)
	[as] <别名>
[where <条件表达式>]
[group by <列名1> [having <条件表达式>] ]	/* having=where,只是group by时只能用having表示限制条件 */
[order by <列名2> [asc|desc] ];
3.5 数据更新
3.5.1 插入数据
两种插入数据方式:
- 插入元组
- 插入子查询结果:一次插入多个元组
1.插入元组
官方写法:
insert into <表名> [(<属性列1>,<属性列2>,...)]
values (<常量1>[,<常量2>]...);
例1:将一个新学生元组(学号:201215128;姓名:陈冬;性别:男;所在系:IS;年龄:18岁)插入到Student表中
insert INTO Student (Sno, Sname,Ssex, Sdept, Sage)
values('201215128','陈冬','男','IS',18);
例2:插入一条选课记录('201215128','1')
insert into SC(Sno,Cno)
values('201215128','1');
/* 或者 */
insert into SC
values('201215128','1',NULL);
2.插入子查询结果
官方写法:
insert into <表名> [(<属性列1>,<属性列2>,...)]
子查询;
/* 子查询输出的列必须与目标列相同 */
例1:对每一个系,求学生的平均年龄,并把结果存入数据库
/* ①建表 */
create table Dept_age
(Sdept char(15)
Avg_age smallint unique);

/* ②插入数据 */
insert into Dept_age(Sdept, Avg_age)
	select Sdept,Avg(Sage)
	from Student
	group by Sdept;
3.5.2 修改数据
官方写法:
update <表名>
set <列名>=<表达式>[,<列名>=<表达式>,...]
[where <条件>];
功能:
- 修改指定表中满足where子句条件的元组
- set子句给出<表达式>的值用于取代相应的属性列
- 如果省略where子句,表示要修改表中的所有元组
三种修改方式:
- 修改某一个元组的值
- 修改某多个元组的值
- 带子查询的修改语句
1.修改某一个元组的值
例1:将学生'201215121'的年龄改为22岁
update Student
set Sage=22
where Sno='201215121';
2.修改某多个元组的值
例2:将所有学生的年龄+1岁
update Student
set Sage=Sage+1;
3.带子查询的修改语句
例3:将计算机系全体学生的成绩置为零
update SC
set Grade=0
where Sno IN
	(select Sno
	from Student
	where Sdept='CS');
3.5.3 删除数据
官方写法:
delete
from <表名>
[where <条件>];
功能: 删除指定表中满足where子句条件的元组
三种删除方式:
- 删除某一个元组的值
- 删除某多个元组的值
- 带子查询的删除语句
1.删除某一个元组的值
例1:删除学生'201215121'
delete
from Student
where Sno='201215121';
2.删除某多个元组的值
例2:删除所有学生的选课记录
delete
from SC;
3.带子查询的删除语句
例3:将计算机系全体学生的选课记录删除
delete
from SC
where Sno IN
	(select Sno
	from Student
	where Sdept='CS');
3.6 空值的处理
空值就是“不知道”或“不存在”或“无意义”的值。
一般有以下几种情况:
- 该属性应该有一个值,但目前不知道它的具体值
- 该属性不应该有值
- 由于某种原因不便于填写
3.6.1 空值的产生
不赋值默认为空,赋NULL也为空
例1:向SC表中插入一个元组,学生号是”201215126”,课程号是”1”,成绩为空。
insert into SC
values('201215126','1',NULL);
3.6.2 空值的判断
判断一个属性是否为空,用IS NULL或IS NOT NULL来判断
例2:从Student表中找出漏填了数据的学生信息
select *
from Student
where Sname IS NULL or Ssex IS NULL
	or Sage IS NULL or Sdept IS NULL;
3.6.3 空值的约束条件
属性定义中:
- 主属性不能取空
- 有
UNIQUE限制的属性不能取空 - 有
NOT NULL约束条件的不能取空
3.6.4 空值的算术运算、比较运算和逻辑运算
-
空值与另一个值(包括另一个空值)的算术运算的结果为空值
-
空值与另一个值(包括另一个空值)的比较运算的结果为UNKNOWN。
-
有UNKNOWN后,传统二值(TRUE,FALSE)逻辑就扩展成了三值逻辑。运算逻辑如下表:
![image]()
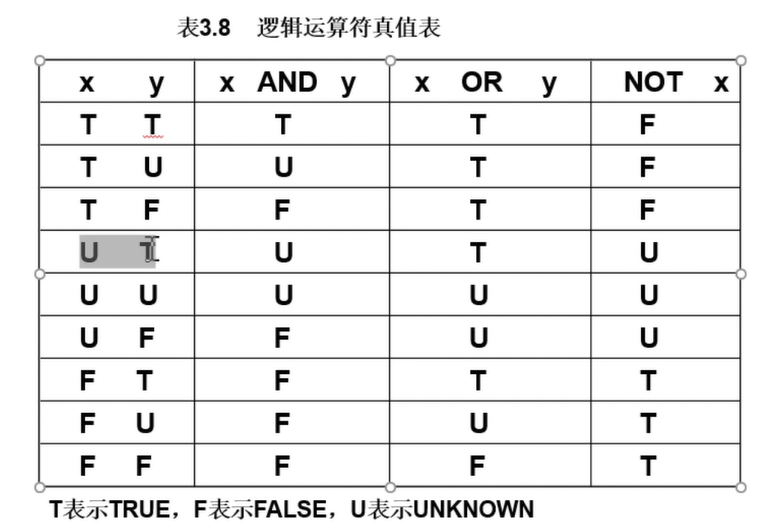
例3:选出选修1号课程的希及格的学生以及缺考的学生。
select Sno
from SC
where Cno='1' and (Grade<60 or Grade IS NULL);
3.7 视图
视图的特点:
- 虚表。是从一个或几个基本表(或视图)导出的表
- 视图只存放视图的定义,不存放视图对应的数据
- 基本表中的数据发生变化,从视图中查询出的数据也随之改变
3.7.1 定义视图
1.建立视图
官方写法:
create view <视图名> [(<列名>,<列名2>,...)]
as <子查询>
[with check option];

/*
with check option:对视图进行UPDATE,INSERT和DELETE操作时要保证更新、插入或删除的行满足视图定义中的谓词条件(即子查询中的条件表达式)
子查询可以是任意的select语句,是否可以含有order by子句和distinct由具体实现决定
*/
若一个视图是从单个基本表导出的,并且只是去掉了基本表的某些行和某些列,但保留了主键,我们称这类视图为行列子集视图。
例1:建立信息系学生的视图
create view IS_Student
as
select Sno,Sname,Sage	/* 最好指定属性列。如果用'*'的话,一旦修改原表的列,就容易出错 */
from Student
where Sdept='IS';
基于多个基本表的视图:
例2:建立信息系选修了1号课程的学生的视图(包括学号、姓名、成绩)
create view IS_S1(Sno,Sname,Grade)
as
select Student.Sno,Sname,Grade
from Student,SC
where Student.Sno=SC.Sno
	and Sdept='IS' and SC.Cno='1';
基于视图的视图:
例3:建立信息系选修了1号课程且成绩在90分以上的学生的视图
create view IS_S2
as
select Sno,Sname,Grade
from IS_S1
where Grade > 90;
分组视图:
例4:将学生的学号及平均成绩定义为一个视图
create view S_G(Sno,Gavg)
as
select Sno,AVG(Grade)
from SC
Group by Sno;
2.删除视图
官方写法:
Drop view <视图名>[cascade];
- 默认不级联
- 如果该视图上还导出了其他视图,使用CASCADE级联删除语句,把该视图和由它导出的所有视图一起删除
- 删除基本表时,由该基表导出的所有视图定义都必须显式地使用DROP VIEW语句删除
例:
drop view IS_S1 cascade;
3.7.2 查询视图
查询视图与查询基本表基本相同
视图消解法由系统自动实现,不用关心。
例1:在信息系学生的视图中找出年龄小于20岁的学生。
select Sno,Sage
from IS_Student
where Sage<20;

/*
视图消解转换后的查询语句为:
select Sno,Sage
from IS_Student
where Sdept='IS' and Sage<20;
*/
3.7.3 更新视图
更新视图的限制: 一些视图是不可更新的,因为对这些视图的更新不能唯一地有意义地转换成对相应基本表的更新。例如平均分视图。
例1:更新
update IS_Student
set Sname='刘辰'
where Sno='201215126';
例2:插入
insert into IS_Student
values('201215129','赵信',20);
例3:删除
delete
from IS_Student
where Sno='201215129';
3.7.4 视图的作用
- 视图能简化用户的操作
- 视图使用户能以多种角度看待同一数据
- 视图对重构数据库提供了一定程度的逻辑独立性
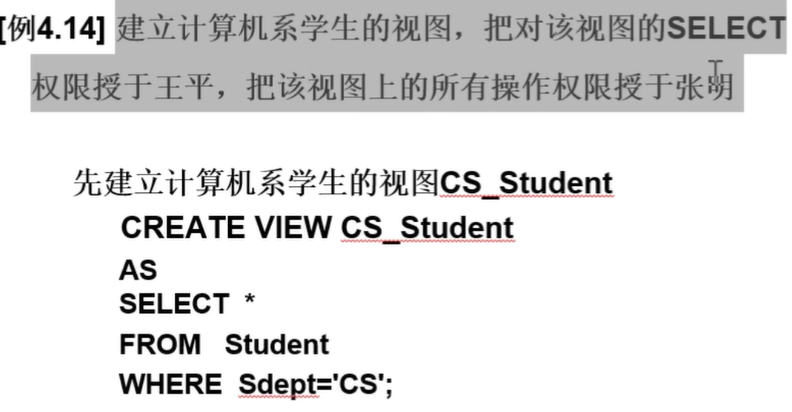
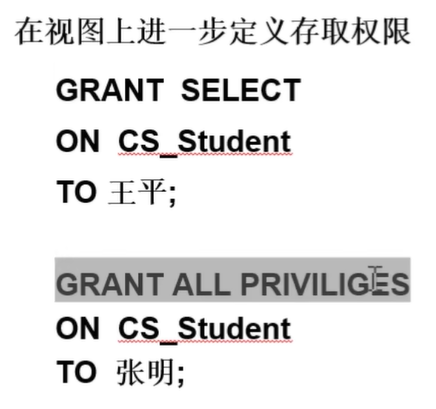
- 视图能够对机密数据提供安全保护
- 适当的利用视图可以更清晰的表达查询
3.8 小结
SQL可以分为数据定义、数据操作(数据查询、数据更新)、数据控制三大部分。
第三章主要讲了数据定义和数据操作
第四、五章将要讲数据控制。数据控制分为两部分:安全性控制和完整性控制
四、数据库安全性
- 数据库的安全性是指保护数据库以防止不合法使用所造成的数据泄露、更改或破坏。
- 系统安全保护措施是否有效是数据库系统主要的性能指标之一。
4.1 数据库安全性概述

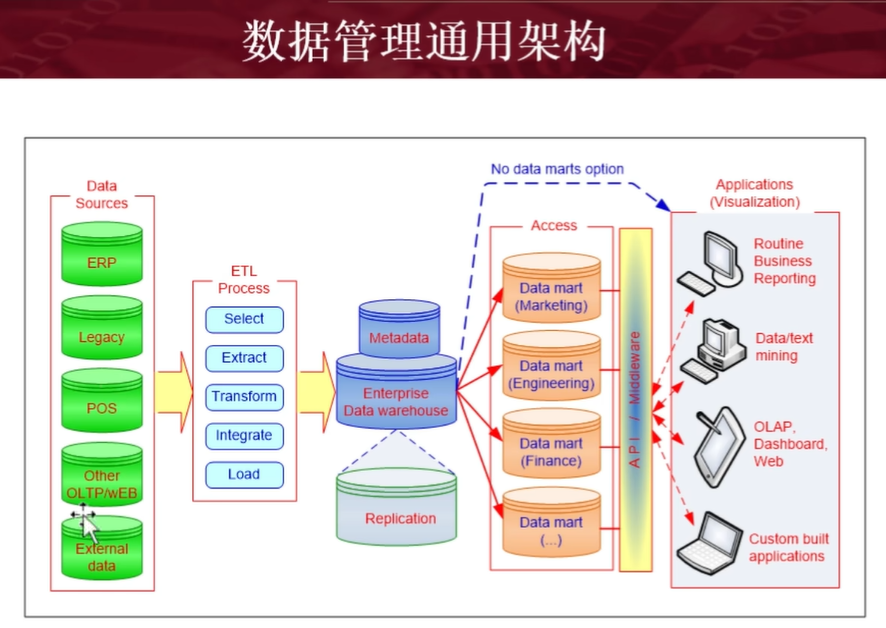
4.1.1 数据库的不安全因素
- 非授权用户对数据库的恶意存取和破坏
- 数据库中重要或敏感的数据被泄露
- 安全环境的脆弱性
4.1.2 安全标准简介
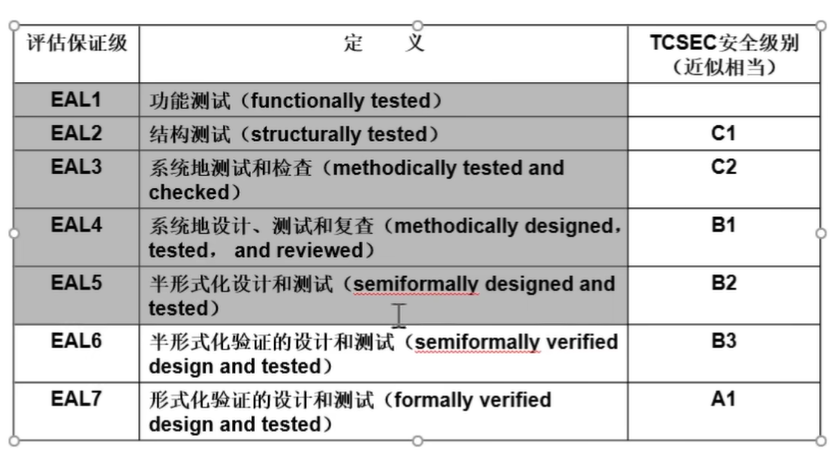
TCSEC标准和CC标准(现在CC用得比较多)
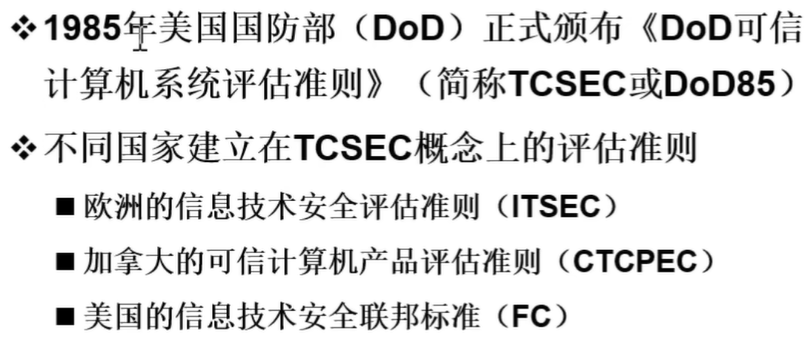
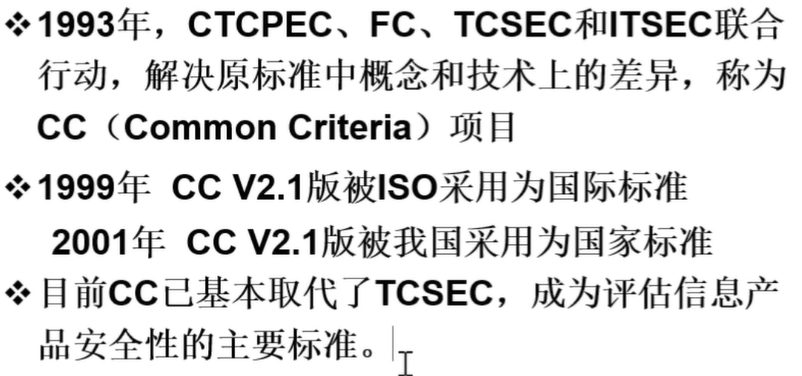
TCSEC安全等级划分:

CC评估保证级划分:
4.2 数据库安全性控制
非法使用数据库的情况:
- 编写合法程序绕过数据库管理系统及其授权机制
- 直接或编写应用程序执行非授权操作
- 通过多次合法查询数据库从中推导出一些保密数据
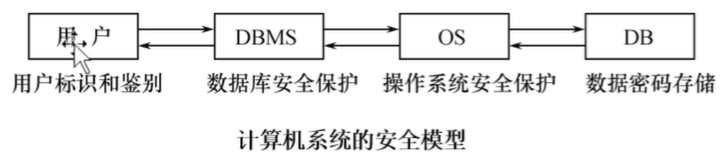
计算机系统中,安全措施是一层一层,层层设置的:
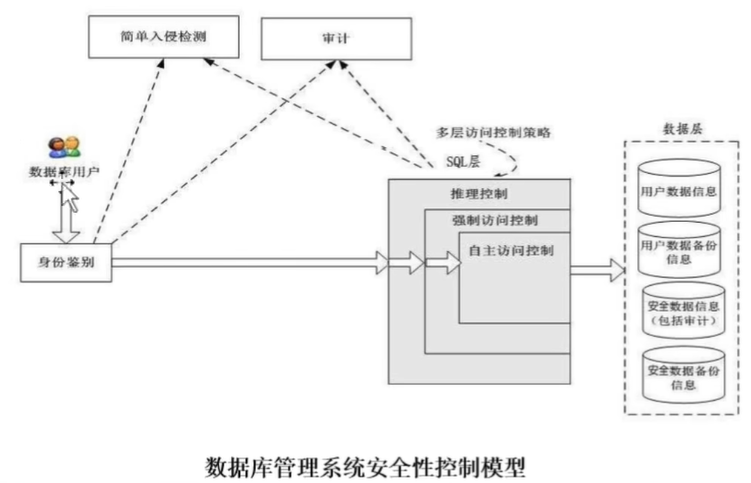
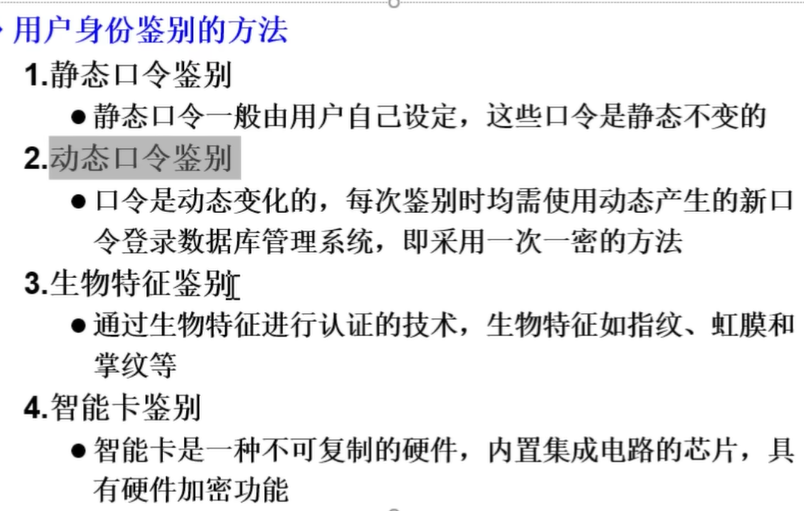
4.2.1 用户身份鉴别
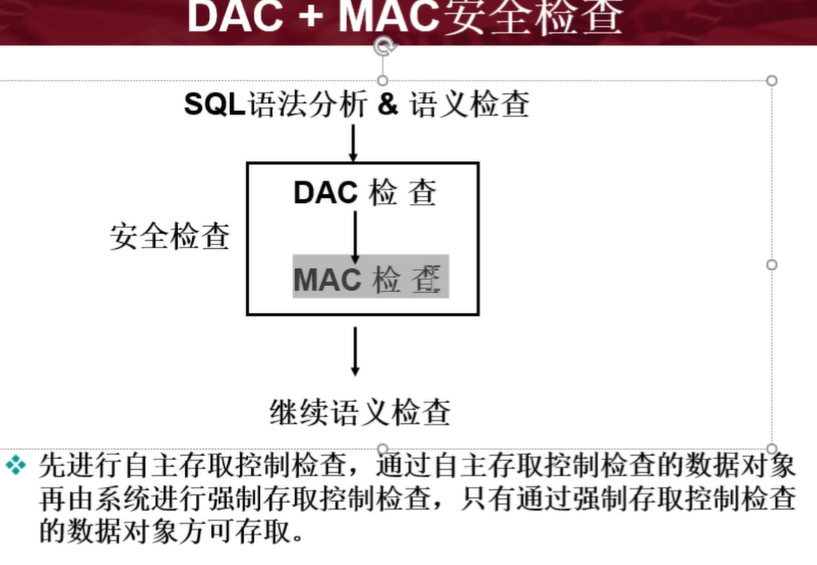
4.2.2 存取控制
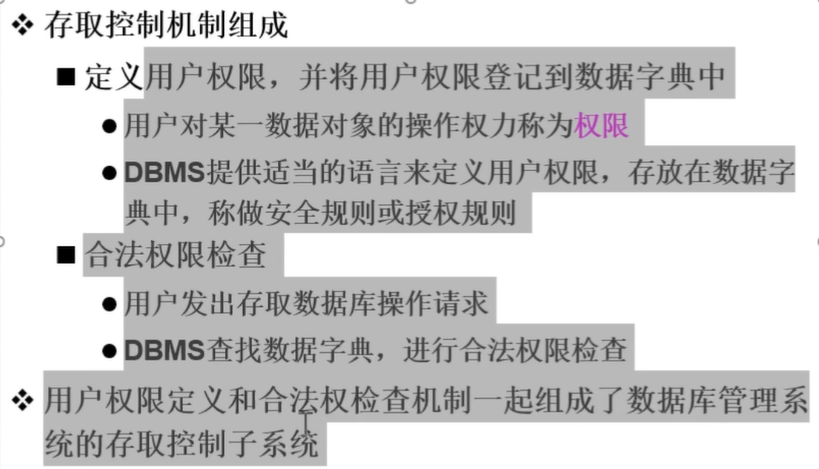
常用存取控制方法:
-
自主存取控制:
- C2级
- 用户对不同的数据对象也有不同的存取权限
- 不同用户对同一对象也有不同的存取权限
- 用户还可以将其拥有的存取权限转授给其他用户
-
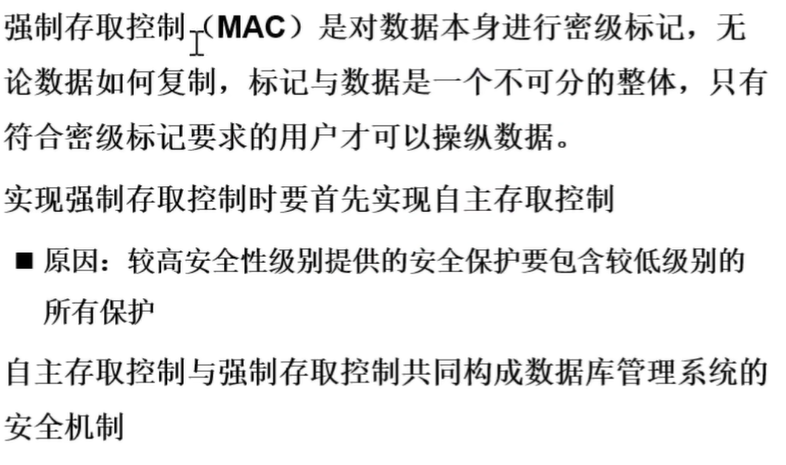
强制存取控制:
B1级

4.2.3 自主存取控制方法


4.2.4 授权:授予与回收
1.Grant
官方写法:
grant <权限1>[,<权限2>,...]
on <对象类型1> <对象名1>[,<对象类型2> <对象名2>,...]
to <用户1>[,<用户2>,...]
[with grant option];
/*
with grant option:权限可以传播给别人
对属性列的授权时必须明确指出相应属性列名:update(Sname)
*/
谁可以发出grant:
- 数据库管理员
- 数据库对象创建者(即属主Owner)
- 拥有该权限的用户
接受授权的用户:
- 一个或多个具体用户
- PUBLIC (即全体用户)
注意:不允许循环授权!
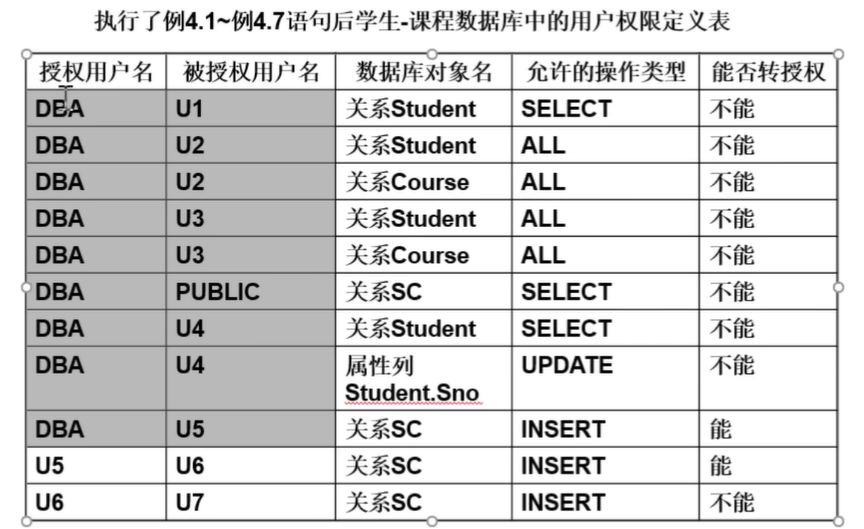
例1:把查询Student表权限授权给用户U1
grant select
on table Student
to U1;
例2:把Student和Course表的全部权限授权给用户U2和U3
grant ALL PRIVILIGES
on table Student,Course
to U2,U3;
例3:把查询SC表权限授权给所有人
grant select
on table SC
to PUBLIC;
例4:把查询Student表和修改学生学号的权限授权给用户U4
grant select,update(Sno)	/* 对属性列的授权时必须明确指出相应属性列名 */
on table Student
to U4;
授权的记录在后台也是一张表
2.revoke
官方写法:
revoke <权限1>[,<权限2>,...]
on <对象类型1> <对象名1>[,<对象类型2> <对象名2>,...]
from <用户1>[,<用户2>,...] [cascade|restrict];
/*
[cascade|restrict]:cascade=级联删除
*/
例1:把U4用户修改学生学号的权限收回
revoke update(Sno)
on table Student
from U4 cascade;
例2:收回所有用户对SC表的查询权限
revoke select
on table SC
from PUBLIC;
3.创建数据库模式的权限
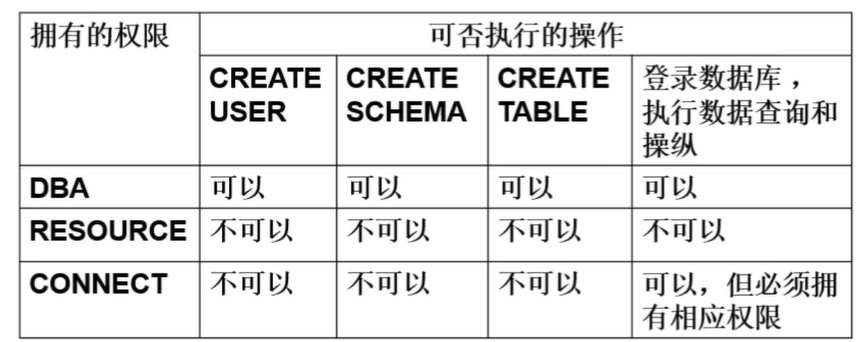
数据库管理员在创建用户时实现
官方写法:
create user <username>
[with] [DBA|RESOURCE|CONNECT];
/*
新创建的数据库用户有三种权限:CONNECT、RESOURCE和DBA
如没有指定创建的新用户的权限,默认该用户拥有CONNECT权限。
只有系统的超级用户才有权创建一个新的数据库用户
拥有CONNECT权限的用户不能创建新用户,不能创建模式,也不能创建基本表,只能登录数据库
*/
4.2.5 数据库角色
数据库角色: 被命名的一组与数据库操作相关的权限。是一个虚拟的概念。
- 角色是权限的集合
- 可以为一组具有相同权限的用户创建一个角色
- 简化授权过程
1.角色的创建
create role <角色名>
2.给角色授权
grant <权限1>[,<权限2>,...]
on <对象类型1> <对象名1>[,<对象类型2> <对象名2>,...]
to <角色1>[,<角色2>,...]
3.将一个角色授予其他的角色或用户
grant <角色1>[,<角色2>,...]
to <角色3>[,<用户1>,...]
[with admin option];
4.角色权限的收回
revoke <权限1>[,<权限2>,...]
on <对象类型1> <对象名1>[,<对象类型2> <对象名2>,...]
from <角色1>[,<角色2>,...] [cascade|restrict];
例:通过角色来实现将一组权限授予一个用户
/* ①创建角色 */
create role R1;

/* ②给角色授权 */
grant select,update,insert
on table Student
to R1;

/* ③把角色授予用户 */
grant R1
to 同学1,同学2;

/* 收回角色 */
revoke R1
from 同学1;
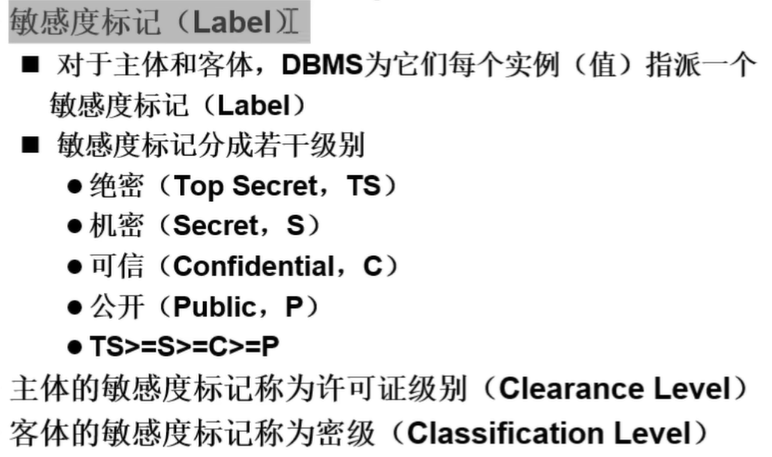
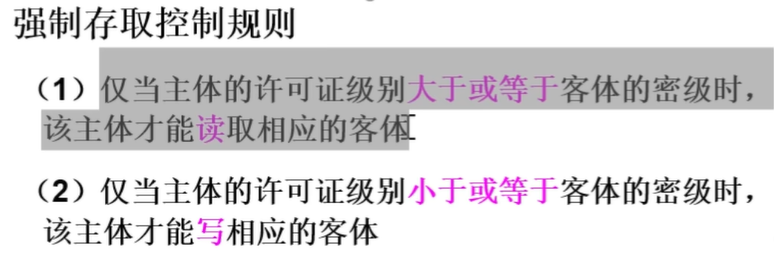
4.2.6 强制存取控制方法

4.3 视图机制
4.4 审计(Audit)
什么是审计:
- 启用一个专用的审计日志(Audit Log),将用户对数据库的所有操作记录在上面
- 审计员利用审计日志,监控数据库中的各种行为,找出非法存取数据的人、时间和内容
- C2以上安全级别的DBMS必须具有审计功能
审计功能的可选性:
- 审计很费时间和空间
- DBA可以根据应用对安全性的要求,灵活地打开或关闭审计功能
1.审计事件
- 服务器事件: 审计数据库服务器发生的事件
- 系统权限: 对系统拥有的结构或模式对象进行操作的审计。要求该操作的权限是通过系统权限获得的。
- 语句事件: 对SQL语句,如DDL、DML、DCL语句的审计
- 模式对象事件: 对特定模式对象上进行的select或DML操作的审计
2.审计功能
-
基本功能:提供多种审计查阅方式
-
多套审计规则:一般在初始化设定
-
提供审计分析和报表功能
-
审计日志管理功能
- 为防止审计员误删审计记录,审计日志必须先存储后删除
- 对转储的审计记录文件提供完整性和保密性保护
- 只允许审计员查阅和转储审计记录,不允许任何用户新增和修改记录等
-
提供查询审计设置及审计记录信息的专门视图
3.AUDIT语句和NOAUDIT语句
-
AUDIT语句:设置审计功能
audit alter,update on SC; -
NOAUDIT语句:取消审计功能
noaudit alter,update
on SC;
4.5 数据加密
4.6 小结
重点: 数据库安全性控制——授权:授予与回收,grant/revoke
五、数据库完整性


5.1 实体完整性
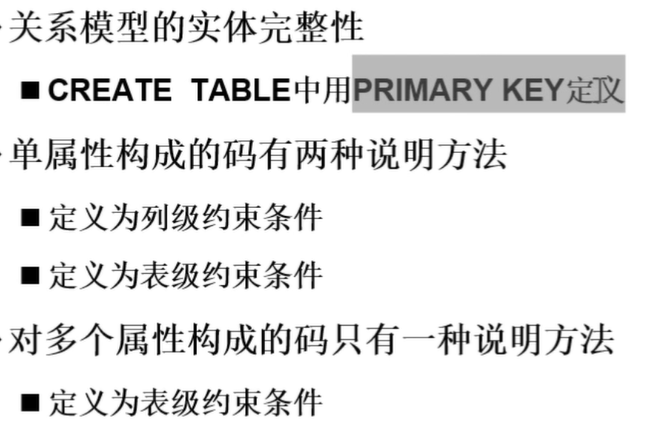
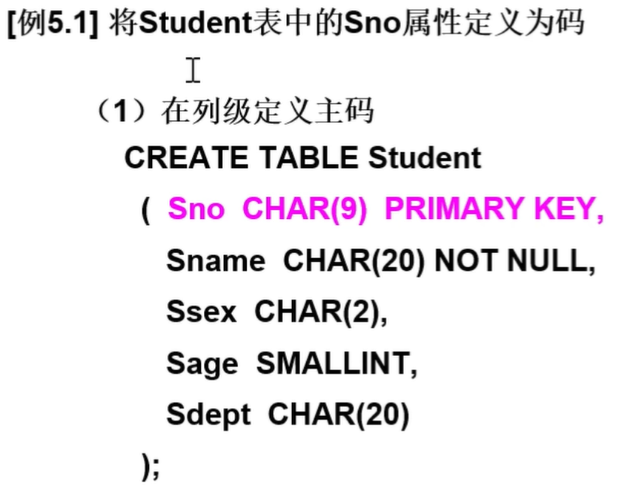
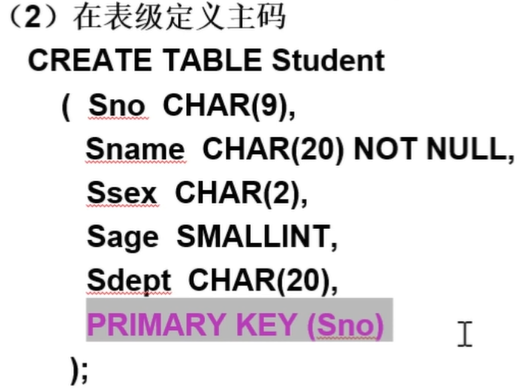
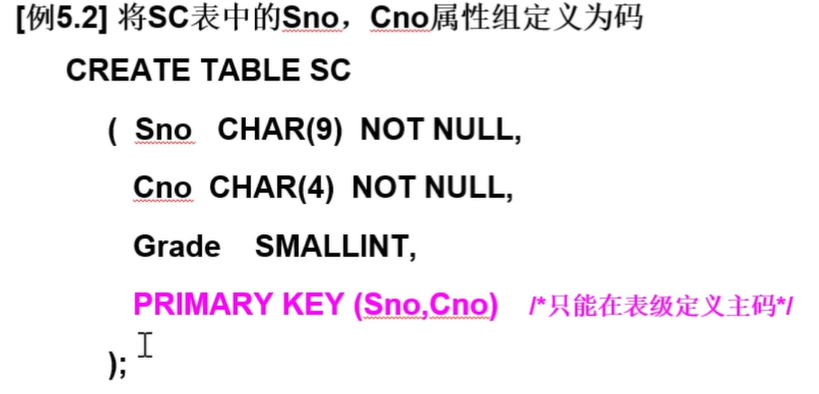
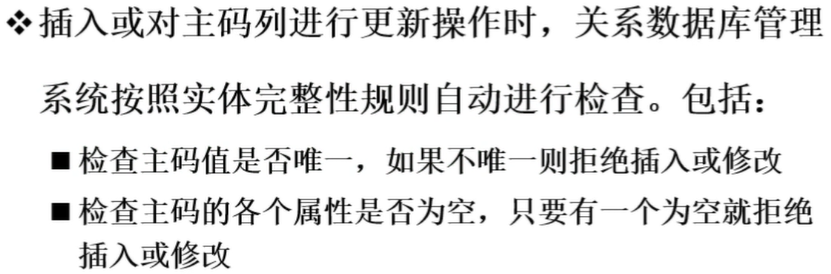
5.1.1 实体完整性定义
主属性不能取空值。
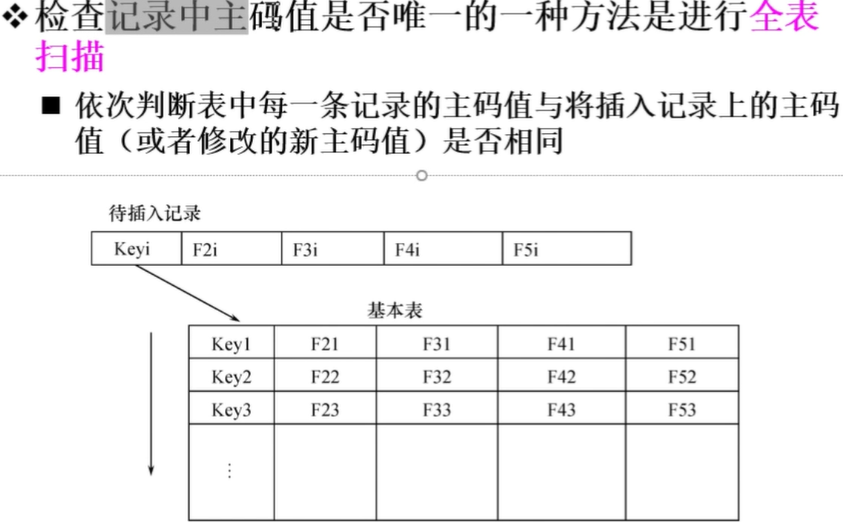
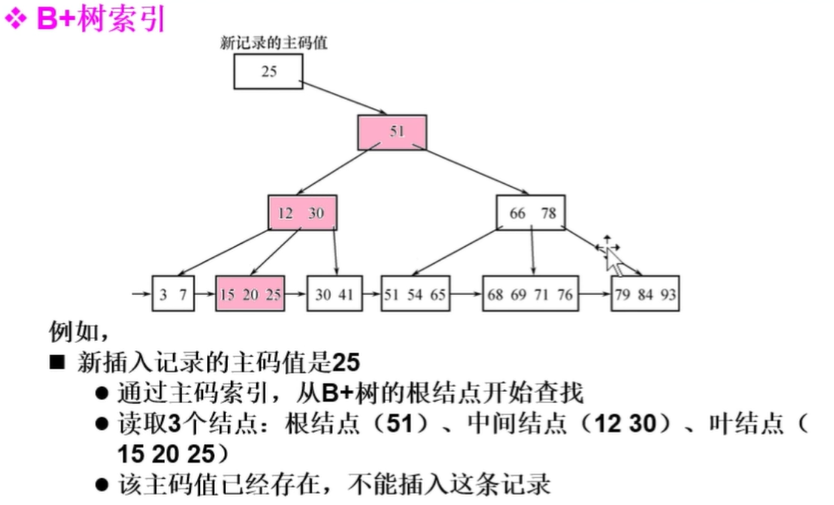
5.1.2 实体完整性检查和违约处理
其实不关心这个具体怎么实现。因为数据库自己会实现。

5.2 参照完整性
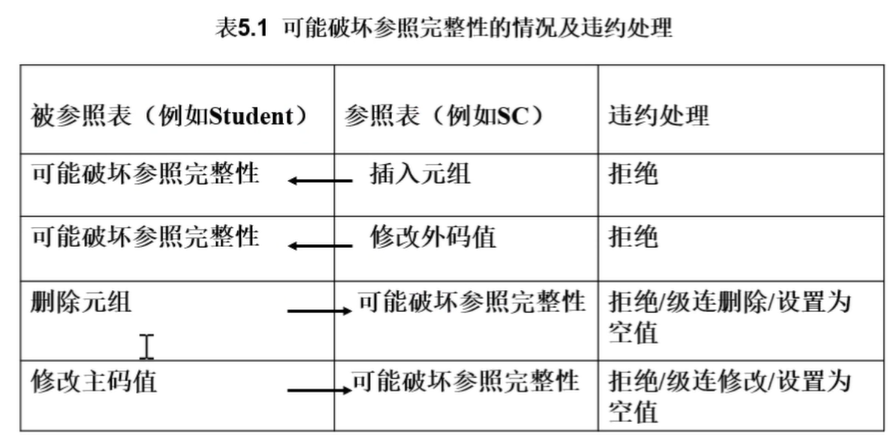
5.2.1 参照完整性定义
互相参照——主键外键

5.2.2 参照完整性检查和违约处理
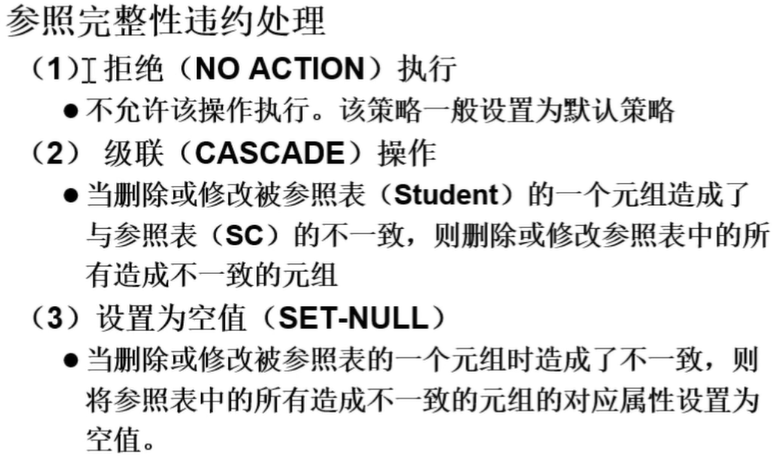
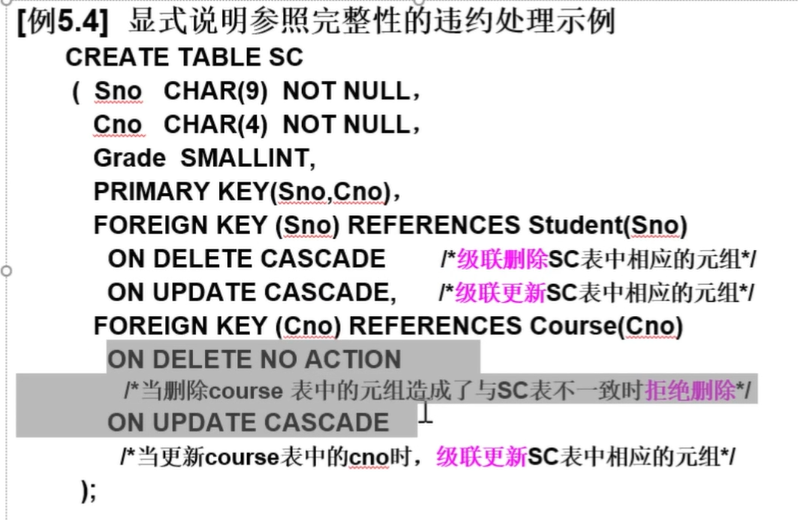
5.3 用户定义的完整性
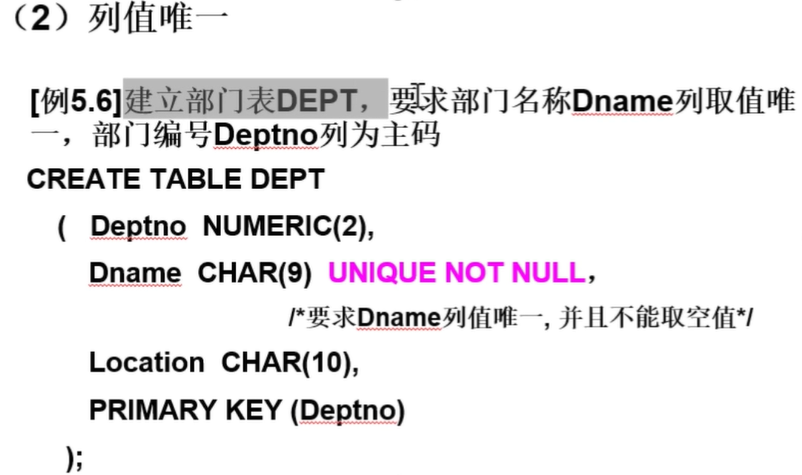
根据需求自定义: 例如性别只能填“男”或“女”
5.3.1 属性上的约束条件
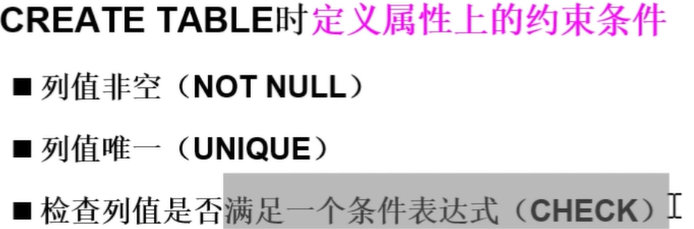
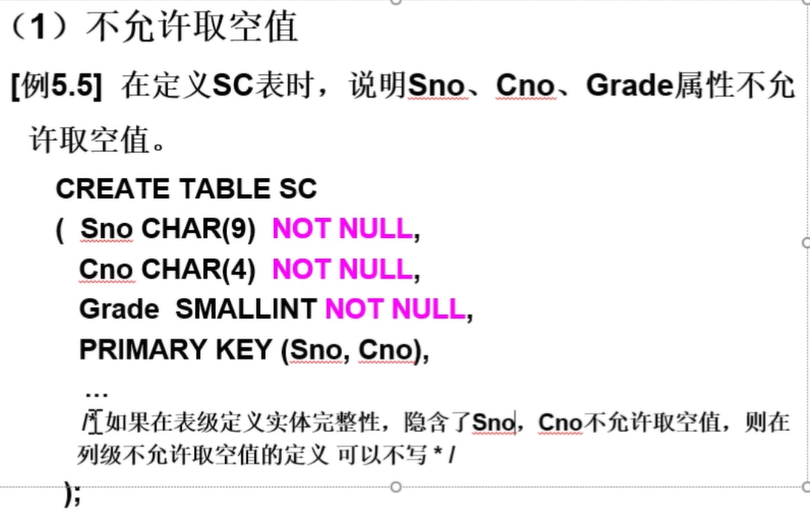


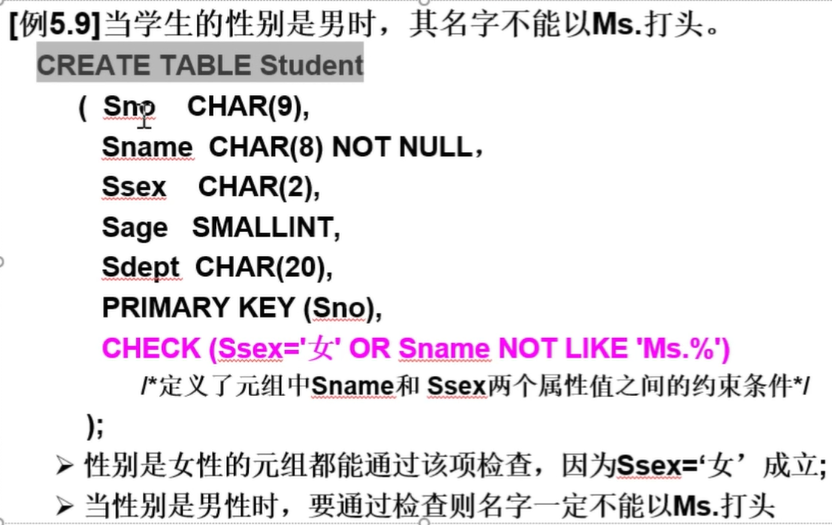
5.3.2 元组上的约束条件
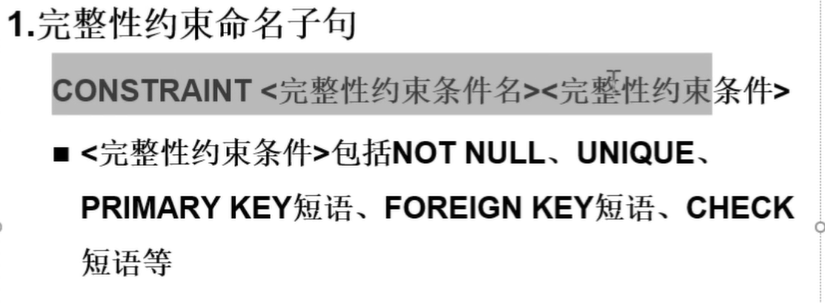
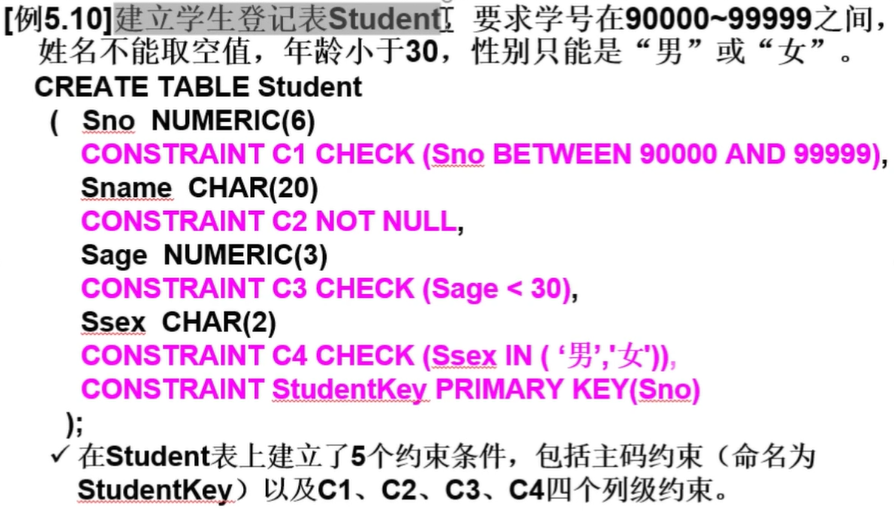
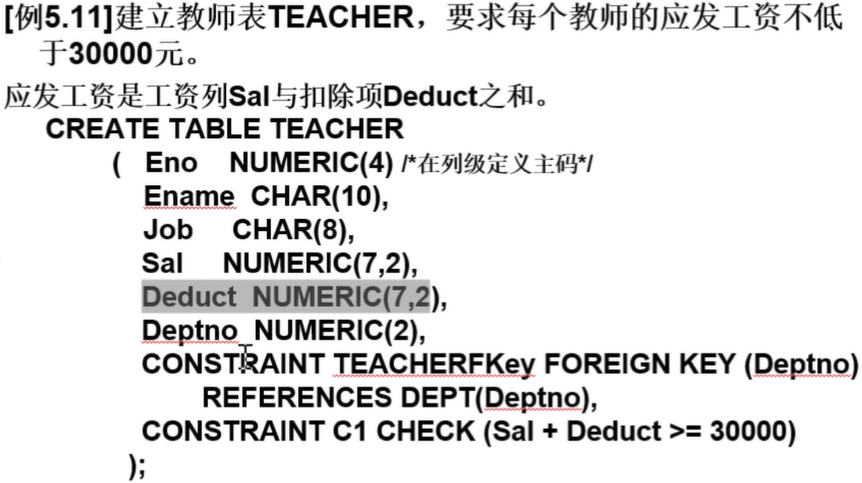
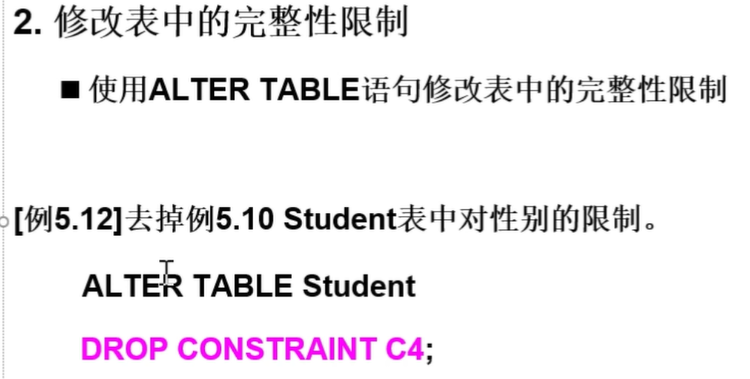
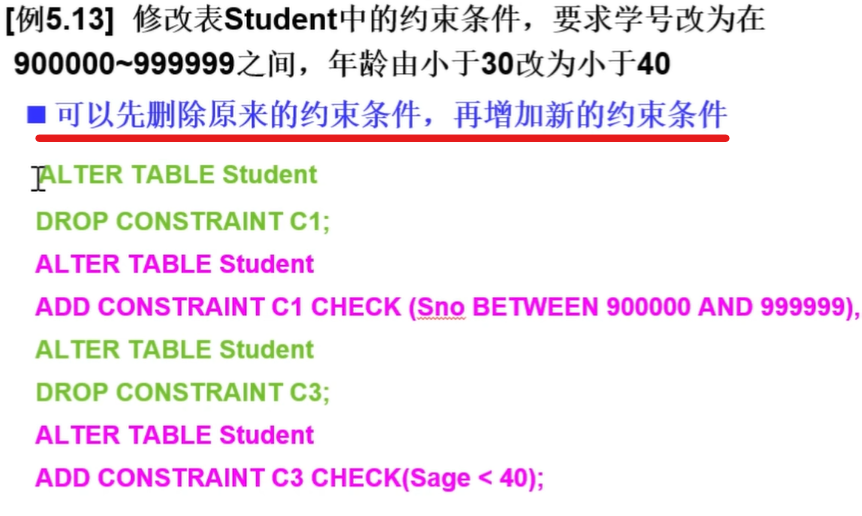
5.4 完整性约束命名子句
5.5 断言
SQL中,可以使用CREATE ASSERTION语句,通过声明性断言来指定更具一般性的约束。
可以定义涉及多个表的,或聚集操作的,比较复杂的完整性约束。
断言创建以后,任何对断言中所涉及的关系的操作都会触发关系数据库管理系统对断言的检查,任何使断言不为真值的操作都会被拒绝执行。
如果断言很复杂,则系统在检测和维护断言的开销较高,这是在使用断言时应该注意的。
1.创建断言的语句格式
官方写法:
create assertion <断言名> <check子句>;
例1:限制数据库课程最多60名学生选修
create assertion asse_SC_DB_num
check(60 >= (select count(*)
			from Cours,SC
			where SC.Cno=Course.Cno
			and Course.Cname='数据库'));
例2:限制每门课程最多60名学生选修
create assertion asse_SC_DB_num
check(60 >= (select count(*)
			from SC
			group by Cno));
2.删除断言的语句格式
官方写法:
drop assertion <断言名>;
5.6 触发器
触发器(Trigger) 是用户定义在关系表上的一类由事件驱动的特殊过程
触发器又叫做事件-条件-动作(event-condition-action)规则。
当特定的系统事件发生时,对规则的条件进行检查,如果条件成立则执行规则中的动作,否则不执行该动作。规则中的动作体可以很复杂,通常是一段SQL存储过程。
- 触发器保存在数据库服务器中
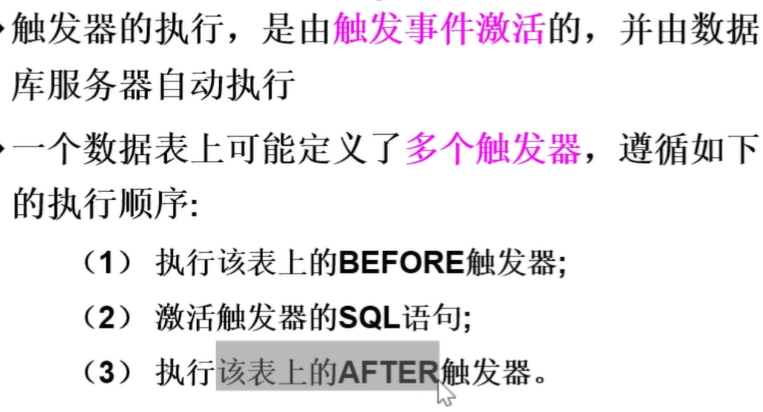
- 任何用户对表的增、删、改操作均由服务器自动激活相应的触发器
- 触发器可以实施更为复杂的检查和操作,具有更精细和更强大的数据控制能力
5.6.1 定义触发器
官方写法:
create trigger <触发器名>
{before|after} <触发事件> on <表名>
referencing new|old row|table as <变量>
for each {row|statemen}
[when <触发条件>]<触发动作体>;
定义触发器的语法说明:
-
表的拥有者才可以在表上创建触发器
-
触发器名
- 触发器名可以包含模式名,也可以不包含模式名
- 同一模式下,触发器名必须是唯一的
- 触发器名和表名必须在同一模式下
-
表名
- 触发器只能定义在基本表上,不能定义在视图上
- 当基本表的数据发生变化时,将激活定义在该表上相应触发事件的触发器
-
触发事件
- 触发事件可以是
insert、delete或update - 还可以
update of <触发列, ...>,即进一步指明修改哪些列时激活触发器 -
after表示在触发事件的操作执行之后激活触发器 -
before表示在触发事件的操作执行之前激活触发器
- 触发事件可以是
-
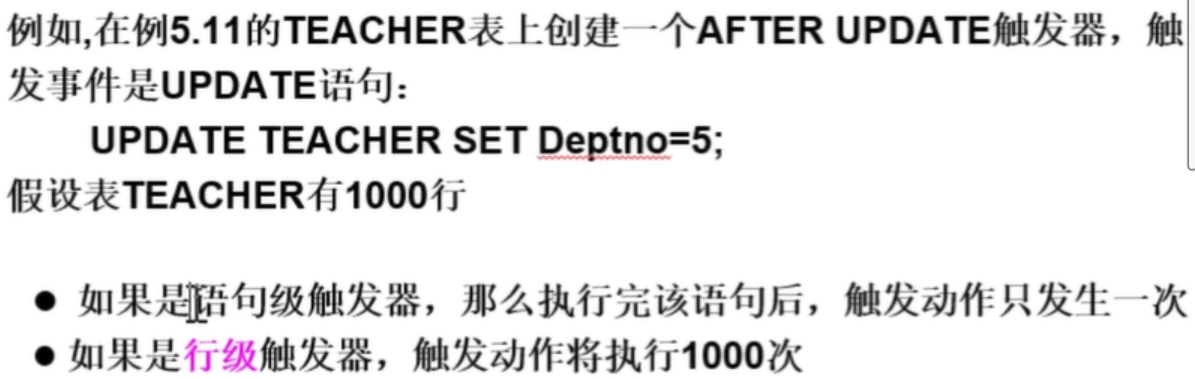
触发器类型
- 行级触发器
- 语句级触发器
-
![image]()
-
触发条件
- 触发器被激活时,只有当触发条件为真时触发动作体才执行;否则触发动作体不执行。
- 如果省略WHEN触发条件,则触发动作体在触发器激活后立即执行
-
触发动作体
- 触发动作体可以是一个匿名PL/SQL过程块也可以是对已创建存储过程的调用
- 如果是行级触发器,用户都可以在过程体中使用NEW和OLD引用事件之后的新值和事件之前的旧值
- 如果是语句级触发器,则不能再触发动作体中使用NEW和OLD进行引用
- 如果触发动作体执行失败,激活触发器的事件就会终止执行,触发器的目标表或触发器可能影响的其他对象不发生任何变化
注意: 不同的RDBMS产品触发器语法各部相同
例1:当对表SC的Grade属性进行修改时,若分数增加了10%,则将此操作记录到下面表中:SC_U(Sno,Cno,Oldgrade,Newgrade)
create trigger SC_T
after update of grade on SC
referencing
	old row as OldTuple,
	new row as NewTuple
for each row
when (NewTuple.Grade >= 1.1*OldTuple.Grade)
	insert into SC_U(Sno,Cno,Oldgrade,Newgrade)
	values(OldTuple.Sno, OldTuple.Cno, OldTuple.Grade, NewTuple.Grade);
例2:将每次对表Student的插入操作所增加的学生个数记录到表StudentlnsertLog中。
create trigger SC_T
after insert on Student
referencing
	new table as delta
for each statement
	insert into StudentInsertLog(Numbers)
	select count(*) from delta;
例3:定义一个BEFORE行级触发器,为教师表Teacher定义完整性规则“教授的工资不得低于40000元,如果低于40000元,自动改为04000元”
create trigger Insert_Or_Update_Sal
before insert or update on Teacher
for each row
begin
	IF (new.job='教授') and (new.Sal < 40000)
	then new.Sal=40000;
	end IF;
end;
5.6.2 激活触发器
5.6.3 删除触发器
官方写法:
drop trigger <触发器名> on <表名>;
触发器必须是一个已经创建的触发器,并且只能由具有相应权限的用户删除。
5.7 小结
数据库的完整性是为了保证数据库中存储的数据是正确的
- 完整性约束条件
- 断言
- 触发器
六、关系数据理论
6.1 问题的提出
【数据库第6章 关系数据理论(第一部分:问题的提出 为什么二维表会有问题)】
关系数据库逻辑设计:
- 针对具体问题,如何构造一个适合于它的数据模式
- 数据库逻辑设计的工具——关系数据库的规范化理论
数据依赖的主要类型:
- 函数依赖 y=f(x)
- 多值依赖 x=f(y)
函数依赖关系:
- 完全依赖
- 部分依赖 | 传递依赖 | 平凡依赖
- 非平凡依赖
关系模式可以形式化地表示为 R( U, D, DOM, F)
- R:关系名
- U:组成该关系的属性名集合
- D:U中属性所来自的域
- DOM:属性向域的映像集合
- F:属性间数据的依赖关系的集合(比如非主属性对主属性是依赖的)
- 由于D、DOM于模式设计关系不大,因此在本章中,把关系模式看作一个三元组:R<U,F>
- 当且仅当U上的一个关系 r 满足 F 时,r 称为关系模式 R<U,F> 的一个关系
- 作为二维表,关系要符合一个最基本的条件:每个分量必须是不可分开的数据项。满足了这个条件的关系模式就属于第一范式(1NF)
一个“好”的模式应当不会发生插入异常、删除异常和更新异常,并且数据冗余应尽可能的少。
坏模式产生的原因: 模式中存在的某些不好的数据依赖引起的
解决方法: 用规范化理论改造关系模式来消除其中不合适的数据依赖
不是所有的数据库都需要规范化为最高级别的范式。因为范式级别越高,数据库性能越低。
将数据库设计到最高级别的范式可能会导致表结构变得过于复杂,查询性能会受到影响。在一些对性能要求较高的场景中,适当放松规范化要求可能会更合适。
6.2 规范化
6.2.1 函数依赖
1.函数依赖
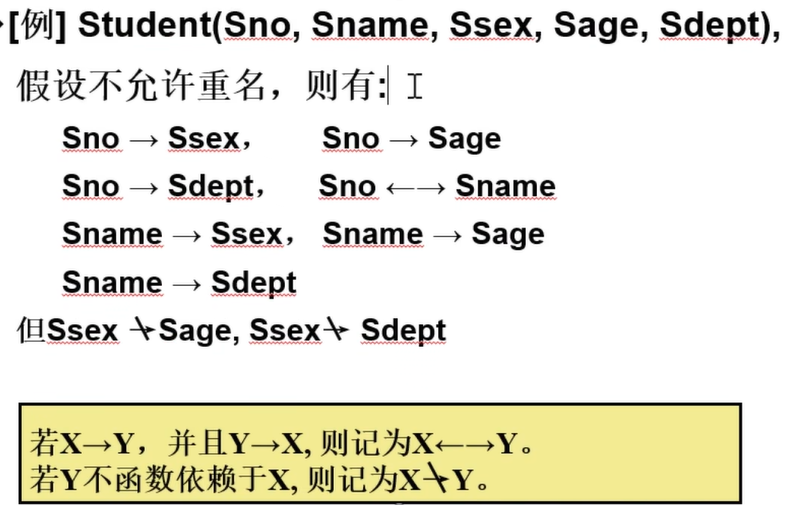
定义: 设R(U)是一个属性集U上的关系模式。X和Y是U的子集。若对于R(U)的任意一个可能的关系r,r中不可能存在两个元组在X上的属性值相等,而在Y上的属性值不等,则称“X函数确定Y”或“Y函数依赖于X” ,记作X→Y。Y = f(x)
2.平凡函数依赖于非平凡函数依赖

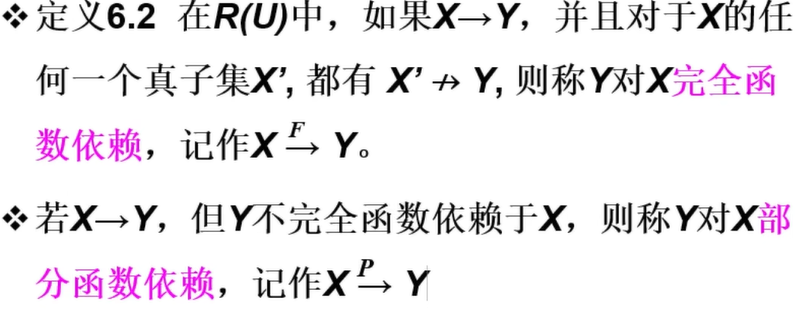
3.完全函数依赖于部分函数依赖
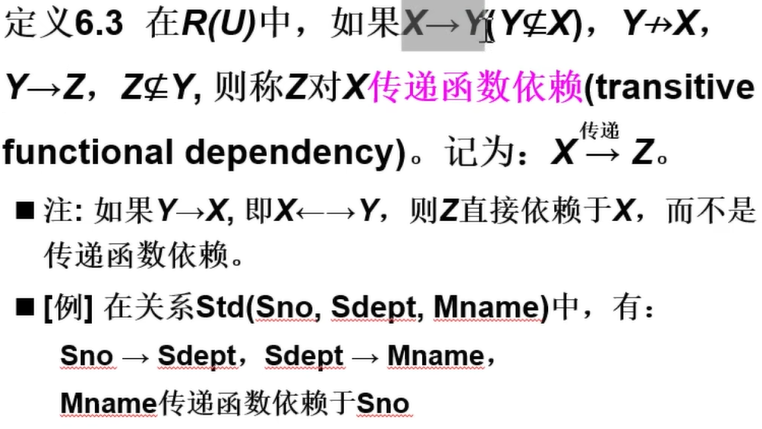
4.传递函数依赖
6.2.2 键

6.2.3 范式
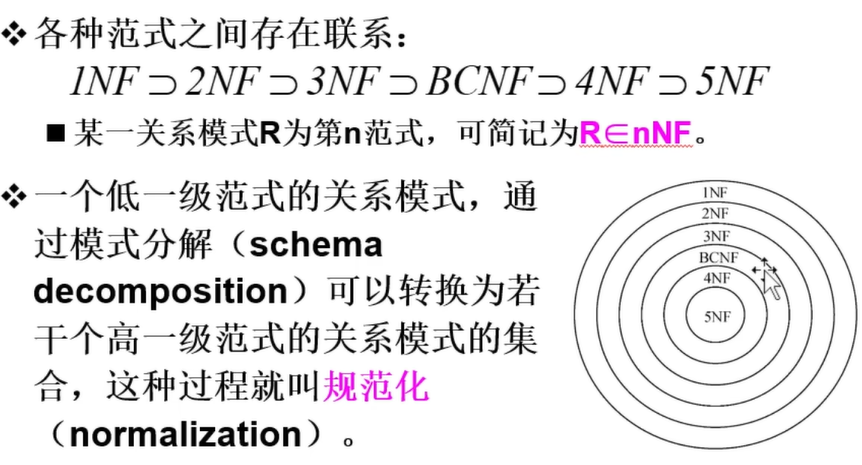
范式是符合某一种级别的关系模式的集合。
关系数据库中的关系必须满足一定的要求。满足不同程度要求的为不同范式。
6.2.4 2NF
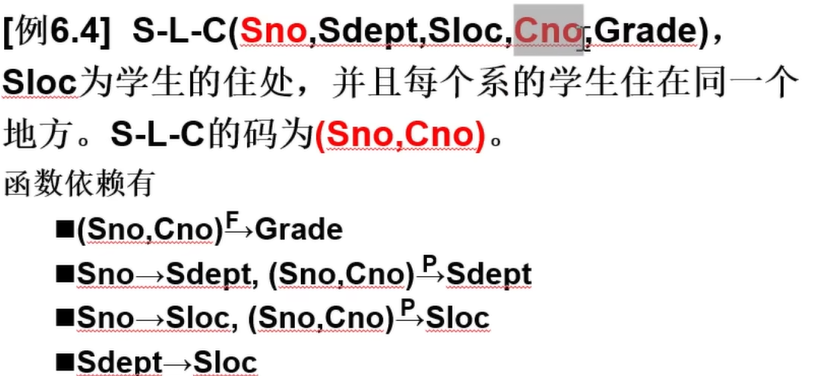
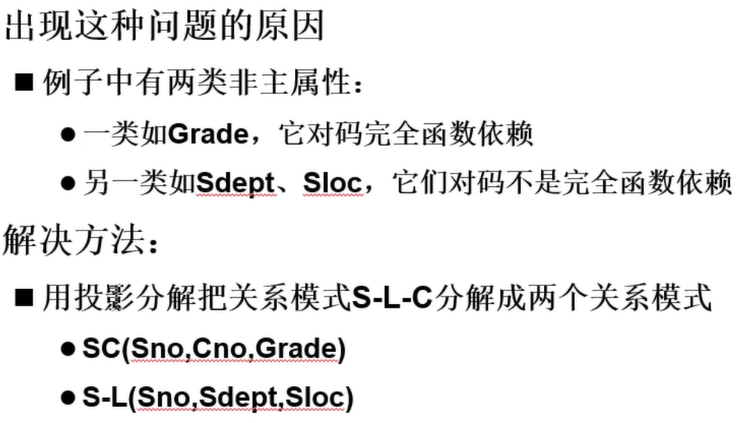
定义: 若关系模式 R∈1NF,并且每一个非主属性都完全函数依赖于任何一个候选码,则 R∈2NF
没有部分依赖
6.2.5 3NF
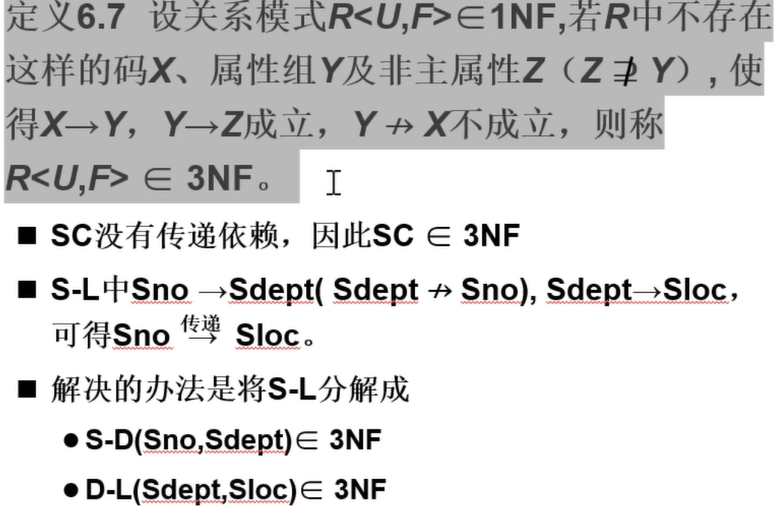
没有传递依赖
6.2.6 BCNF
BCNF由Boyce和Codd提出,比3NF更进了一步。通常认为BCNF是修正的第三范式,有时也称为扩充的第三范式。
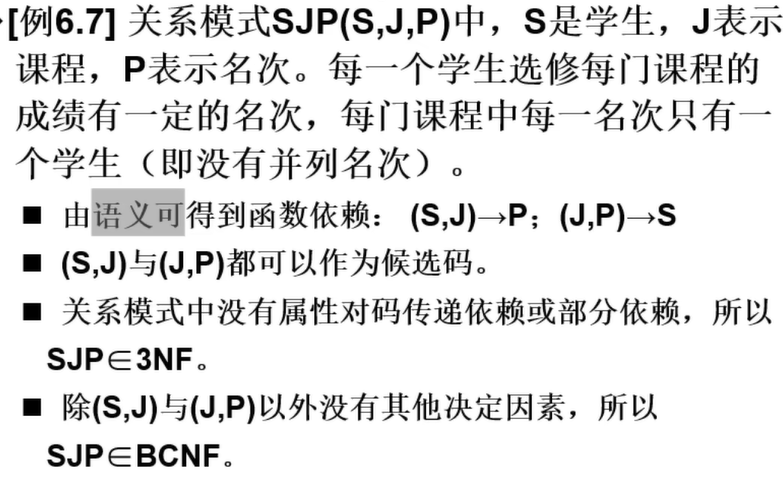
BCNF是3NF的一种特殊情况。消除了主属性内部的部分依赖和传递依赖。
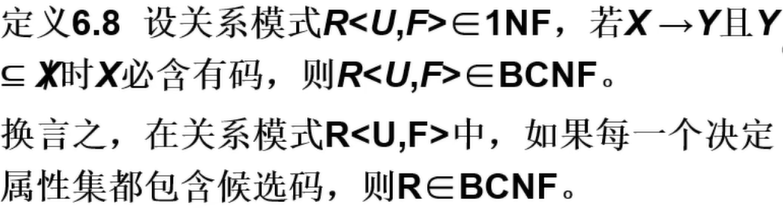
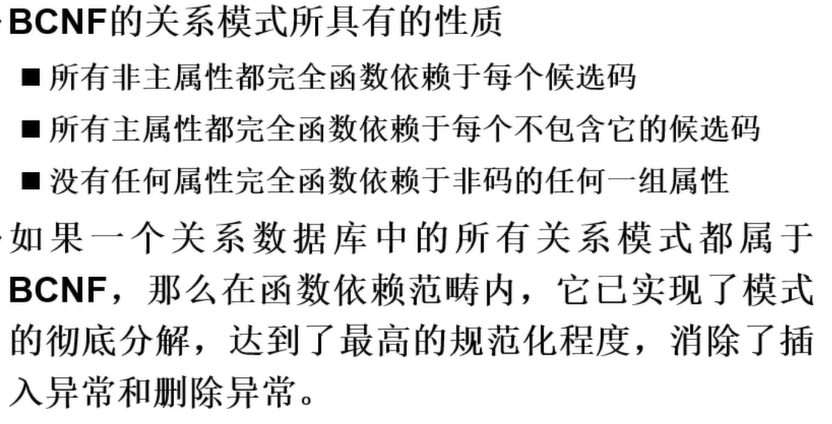

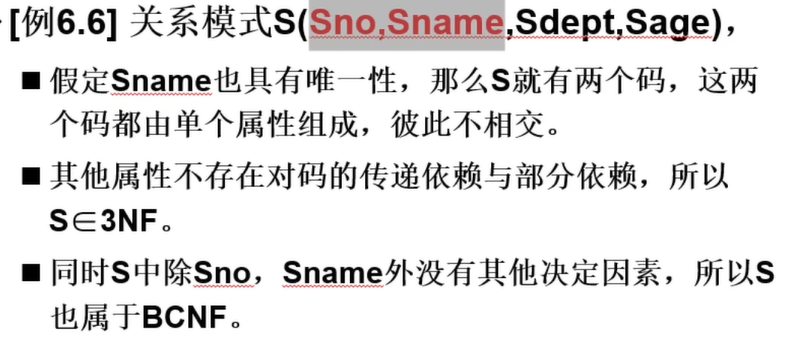
6.2.7 多值依赖
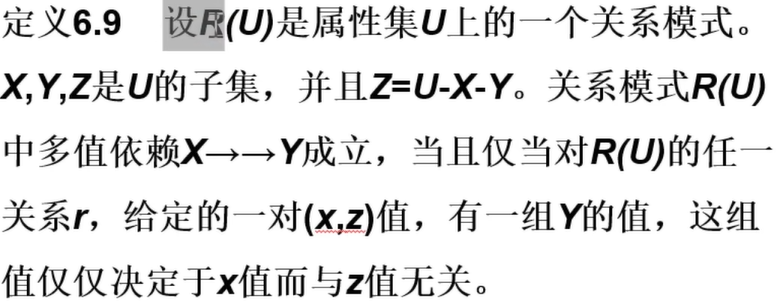
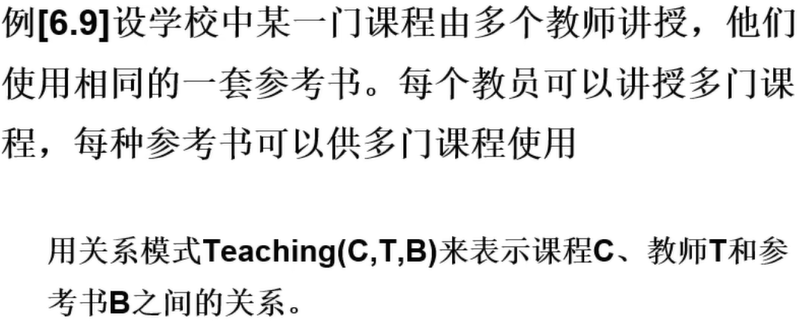
多值依赖:一个 x 对应多个 y
6.2.8 4NF
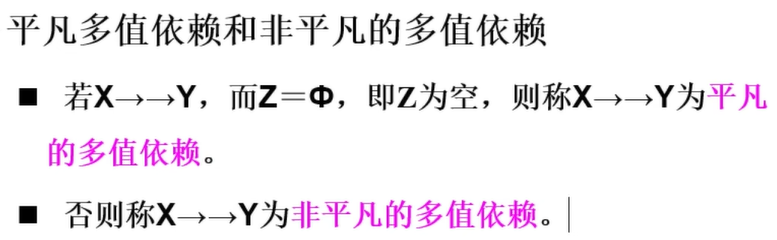
4NF 所允许的非平凡多值依赖实际上是函数依赖。
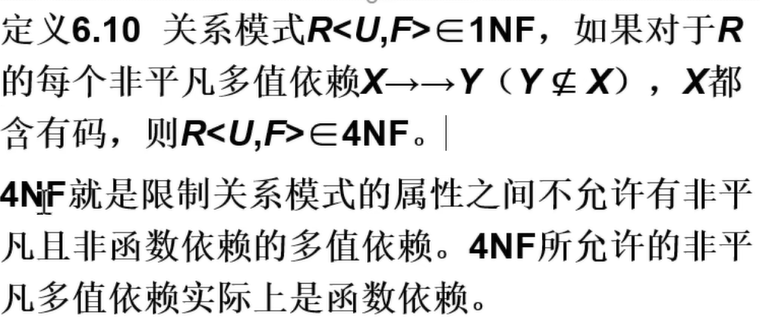
非4NF转换成4NF: 把非平凡的多值依赖拆解成平凡的多值依赖。
6.2.9 规范化小结
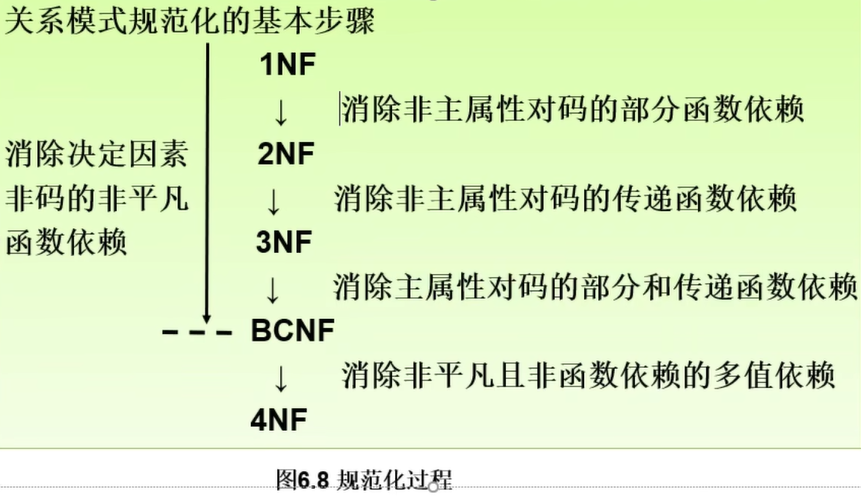
拆分方法:谁跟你好,复制一下自己把它带走
6.3 数据依赖的公理系统
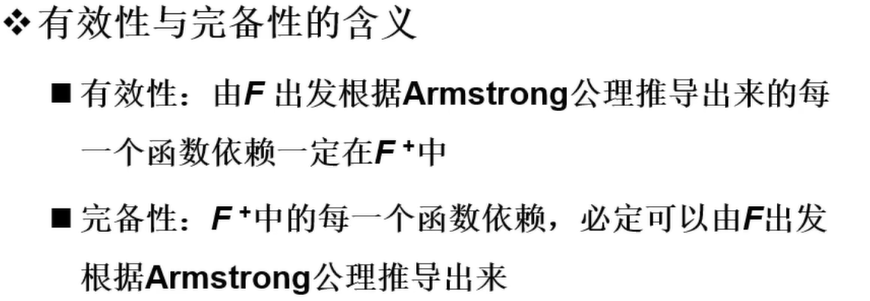
逻辑蕴含的定义: 对于满足一组函数依赖F 的关系模式 R<U, F>,其任何一个关系 r,若函数依赖 X->Y 都成立(即 r 中任意两元组 t、s,若t[X] = s[X],则t[Y] = s[Y]),则称 F 逻辑蕴含 X->Y。逻辑蕴含即表示,在 F表中 X->Y 成立。
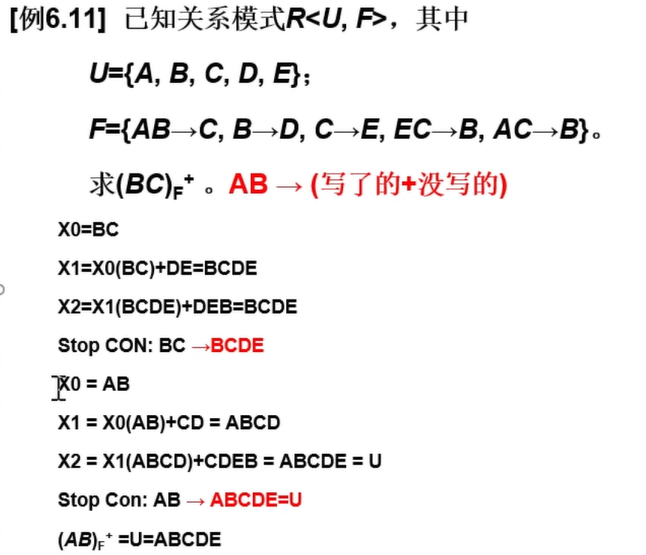
Armstrong公理系统: 一套推理规则,是模式分解算法的理论基础。
用途:
- 求给定关系模式的键
- 从一组函数依赖求得蕴含的函数依赖
Armstrong公理系统:设 U 为属性集总体,F 是 U 上的一组函数依赖,于是有关系模式 R<U, F>。对 R<U, F> 来说有以下的推理规则:
- A1 自反律:若 Y⊆X⊆U,则 X->Y 为 F 所蕴含。
- A2 增广率:若 X->Y 为 F 所蕴含,且 Z⊆U,则 XZ->YZ 为 F 所蕴含
- A3 传递率:若 X->Y 及 Y->Z 为 F 所蕴含,则 X->Z 为 F 所蕴含
根据A1,A2,A3这三条推理规则,可以得到下面三条推理规则:
- 合并规则:由 X->Y,X->Z,有 X->YZ
- 伪传递规则:由 X->Y,WY->Z,有 XW->Z
- 分解规则:由 X->Y 及 Z⊆Y,有 X->Z
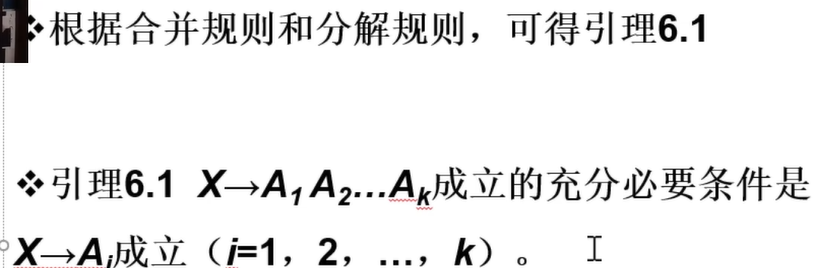

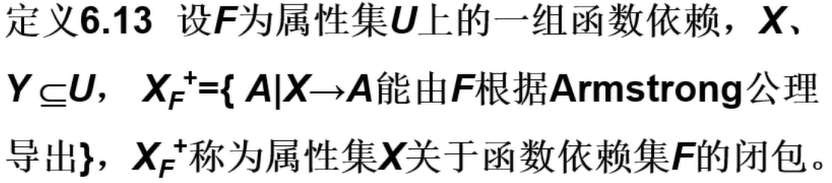
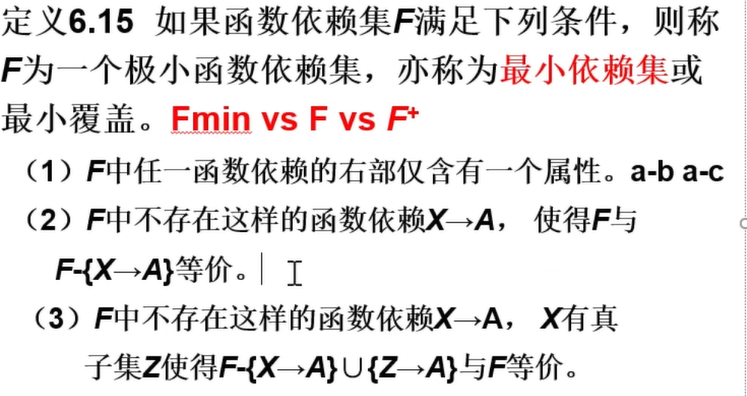
大卞老师说后面这个没学:
七、数据库设计
7.1 数据库设计概述
数据库设计是指对于一个给定的应用环境,构造(设计)优化的数据库逻辑模式和物理结构,并据此建立数据库及其应用系统,使之能够有效地存储和管理据,满足各种用户的应用需求,包括信息管理要求利数据操作要求。
- 信息管理要求:在数据库中应该存储和管理哪些数据对象
- 数据操作要求:对数据对象需要进行哪些操作,如查询、增加、删除、修改、统计等操作。
- 数据库设计的目标是为用户和各种应用系统提供一个信息基础设施和高效率的运行环境。
- 高效率的运行环境指:数据库数据的存取效率高;数据库存储空间的利用效率高;数据库系统运行管理的效率高
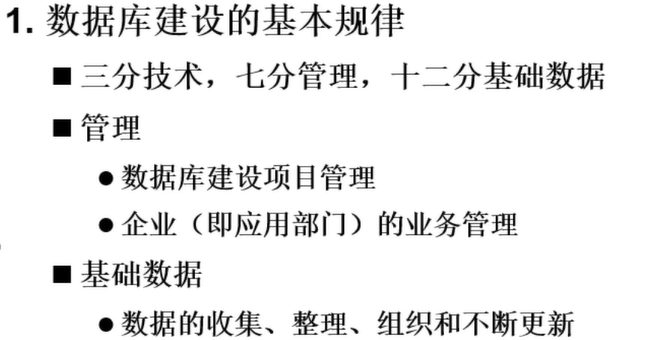
7.1.1 数据库设计的特点
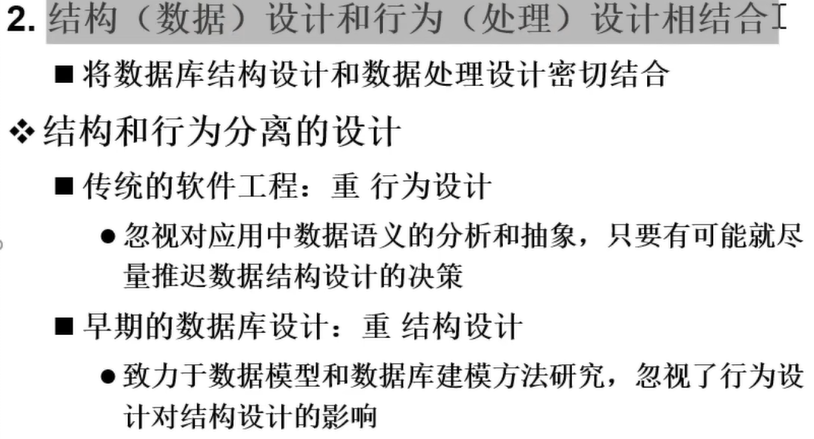
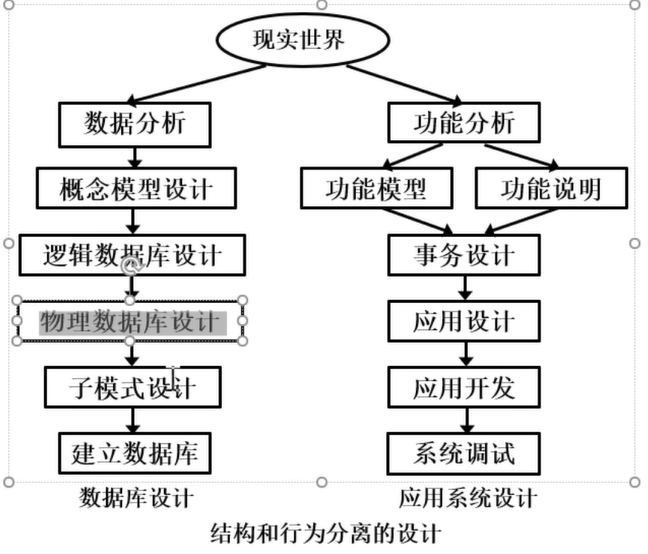
7.1.2 数据库设计方法
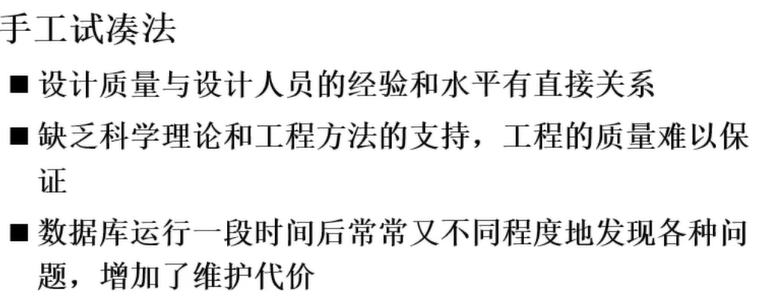
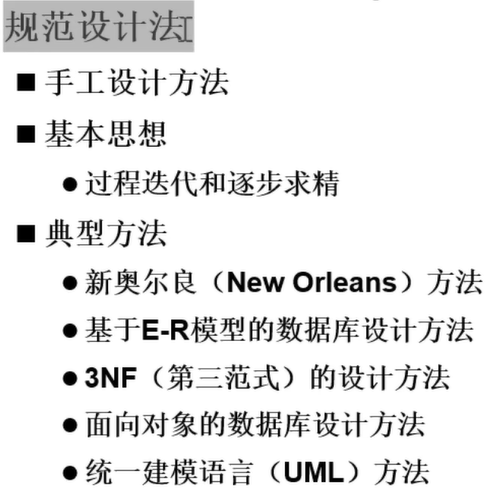
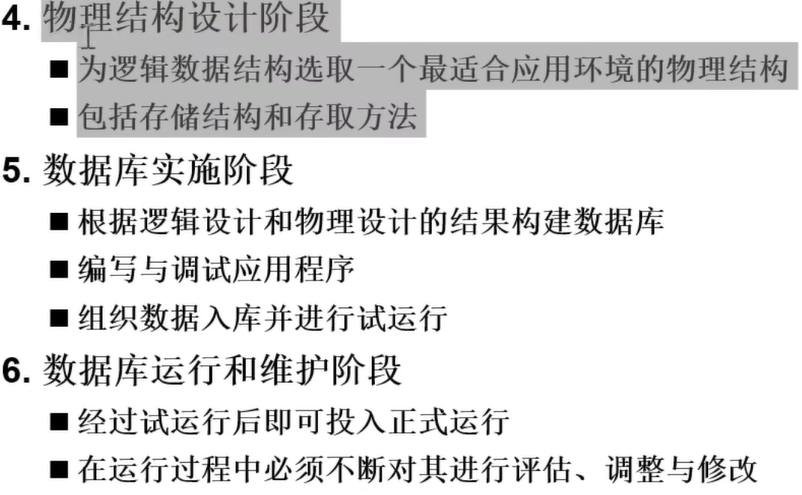
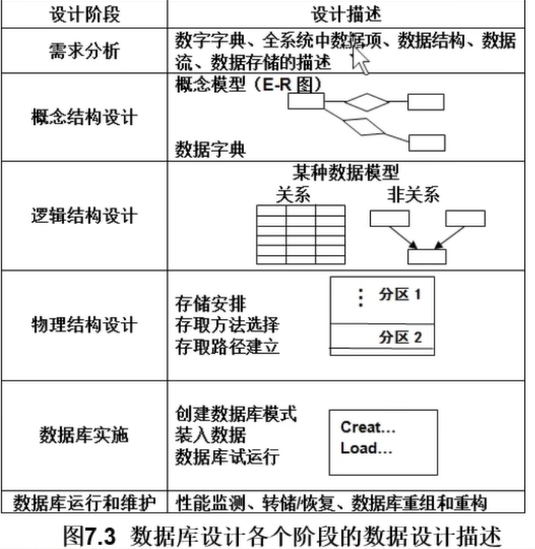
7.1.3 数据库设计的基本步骤

7.1.4 数据库设计过程中的各级模式
7.2 需求分析
需求分析就是分析用户的要求:
- 是设计数据库的起点
- 结果是否准确地反映了用户的实际要求,将直接影响到后面各个阶段的设计,并影响到设计结果是否合理和实用
7.2.1 需求分析的任务
需求分析的方法:
- 详细调查现实世界要处理的对象(组织、部门、企业等)
- 充分了解原系统(手工系统或计算机系统)工作概况
- 明确用户的各种需求
- 在此基础上确定新系统的功能
- 新系统必须充分考虑今后可能的扩充和改变
调查的重点是 “数据”和“处理” ,获得用户对数据库的要求:
-
信息要求:
用户需要从数据库中获得信息的内容与性质
由信息要求可以导出数据要求,即在数据库中需要存储哪些数据 -
处理要求:
用户要完成的处理功能,和对处理性能的要求
-
安全性与完整性要求
确定用户最终需求的难点:
- 用户缺少计算机知识,不能准确地表达自己的需求,他们所提出的需求往往不断地变化。
- 设计人员缺少用户的专业知识,不易理解用户的真正需求,甚至误解用户的需求
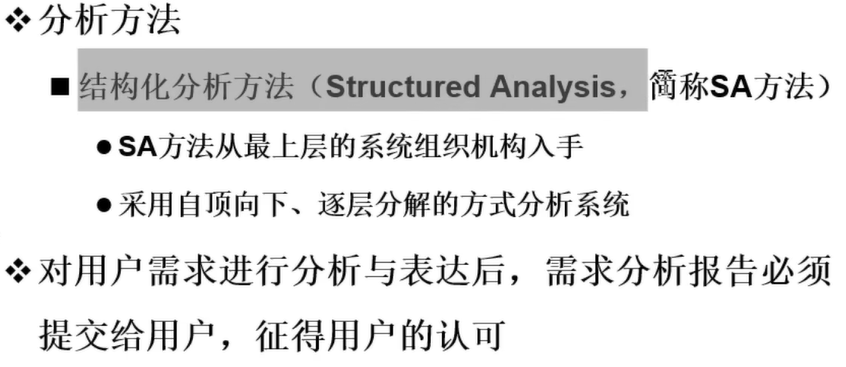
解决方法: 设计人员必须不断深入地与用户进行交流,才能逐步确定用户的实际需求
7.2.2 需求分析的方法

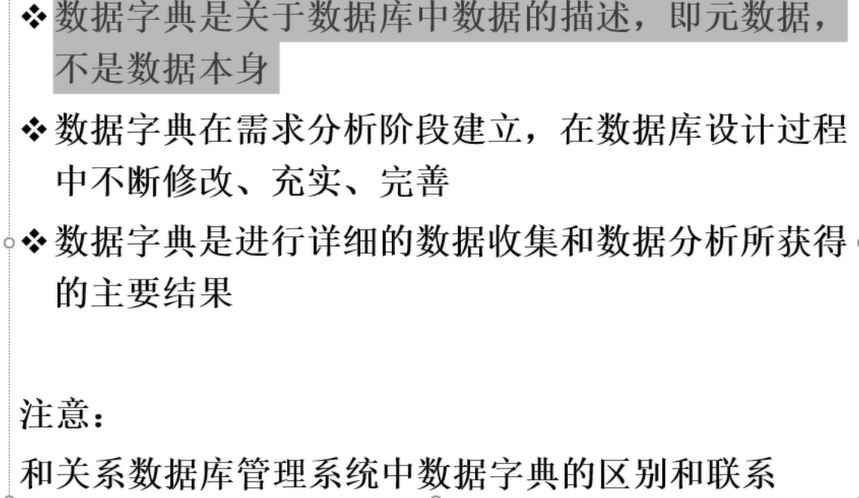
7.2.3 数据字典
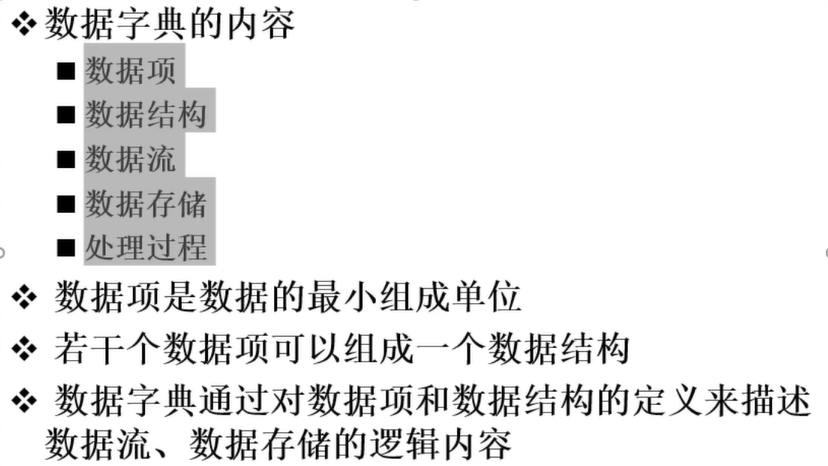
1.数据项

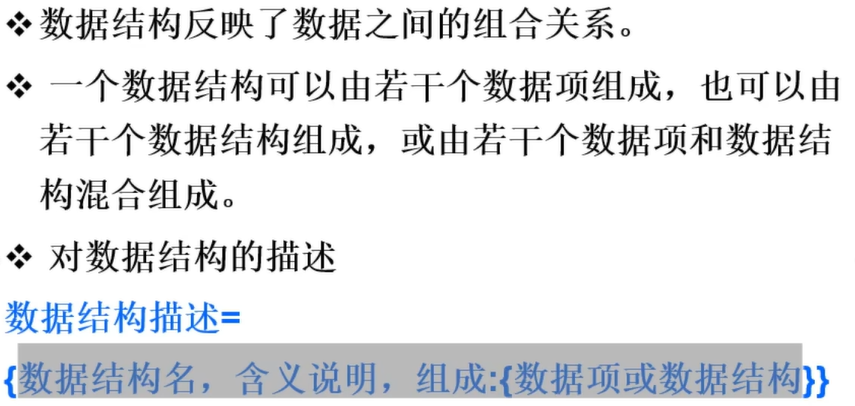
2.数据结构
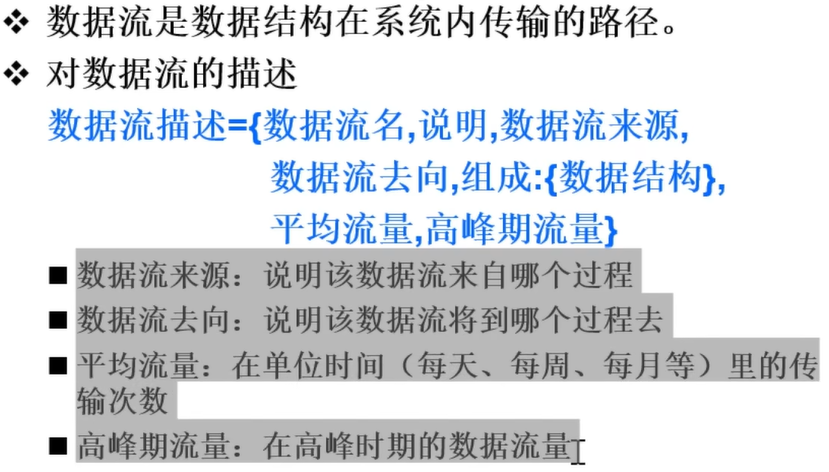
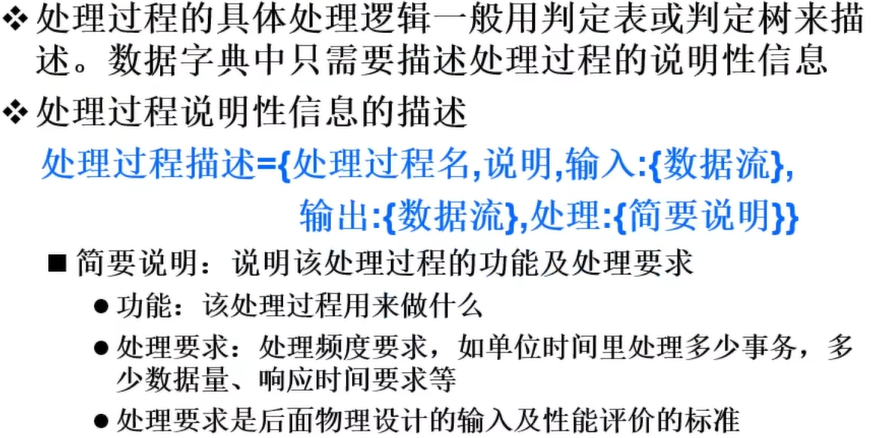
3.数据流
4.数据存储

5.处理过程
7.3 概念结构设计
7.3.1 概念模型
将需求分析得到的用户需求抽象为信息结构(即概念模型)的过程就是概念结构设计
概念模型的特点:
- 能真实、充分地反映现实世界,是现实世界的一个真实模型。
- 易于理解,从而可以用它和不熟悉计算机的用户交换意见。
- 易于更改,当应用环境和应用要求改变时,容易对概念模型修改和扩充。
- 易于向关系、网状、层次等各种数据模型转换
描述概念模型的工具:E-R模型
7.3.2 E-R模型
1.联系
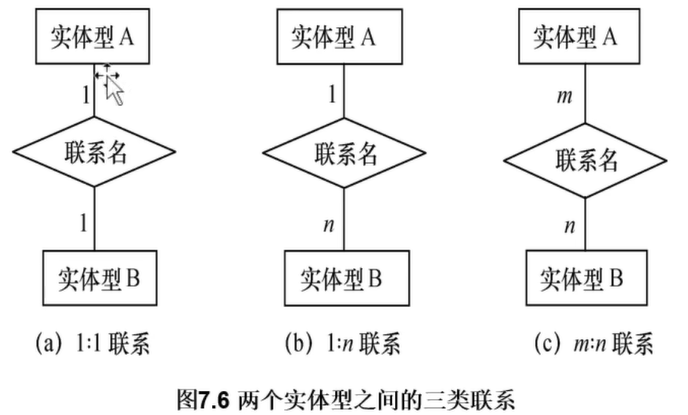
实体间的联系:
-
两个实体之间的联系:
①一对一联系(1:1)
②一对多联系(1:n)
③多对多联系(m:n)
![image]()
-
三个实体间的联系:
![image]()
-
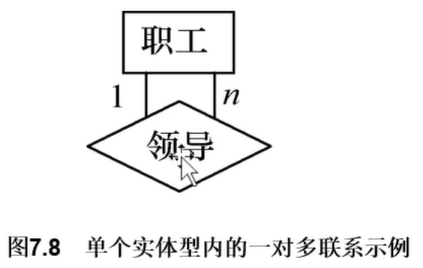
单个实体间的联系:
![image]()

联系的度:参与联系的实体的个数
2.E-R图
E-R图提供了表示实体型、属性和联系的方法:
-
实体型:用矩形表示,矩形框内写明实体名
-
联系:用菱形表示,菱形框内写明联系名,并用五香边分别于有关实体型连接起来,同时在无向边旁注上联系的类型(1:1,1:n,n:m)。联系可以具有属性
![image]()
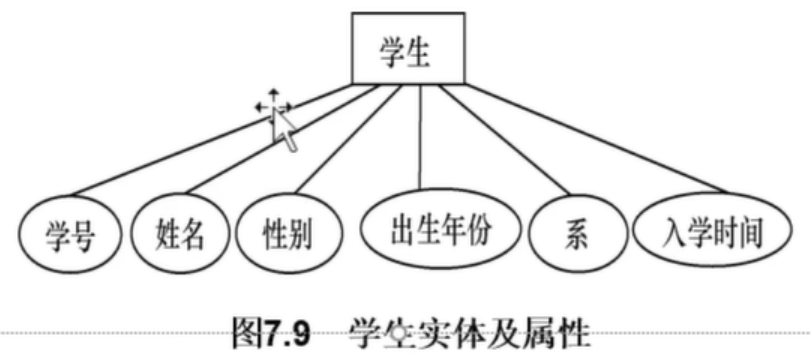
-
属性:用椭圆形表示,并用无向边将其与相应的实体性连接起来。
![image]()
-
画图顺序推荐是:先画实体型,再画联系,最后画属性。免得忘记联系也能有属性。

7.3.3 E-R图
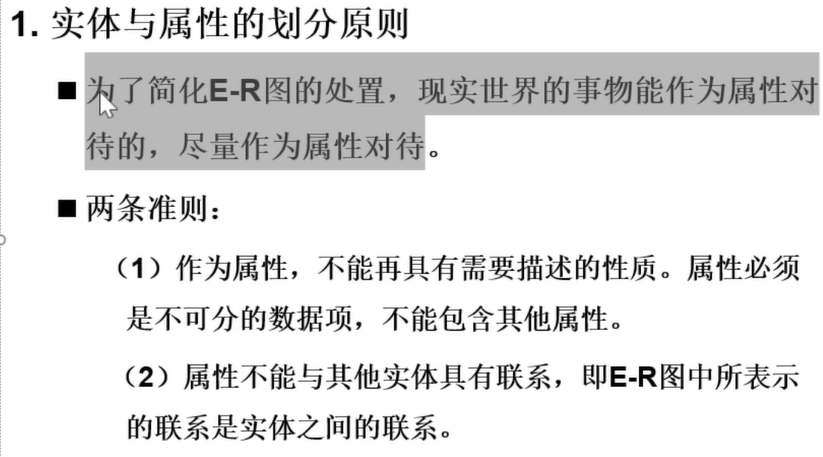
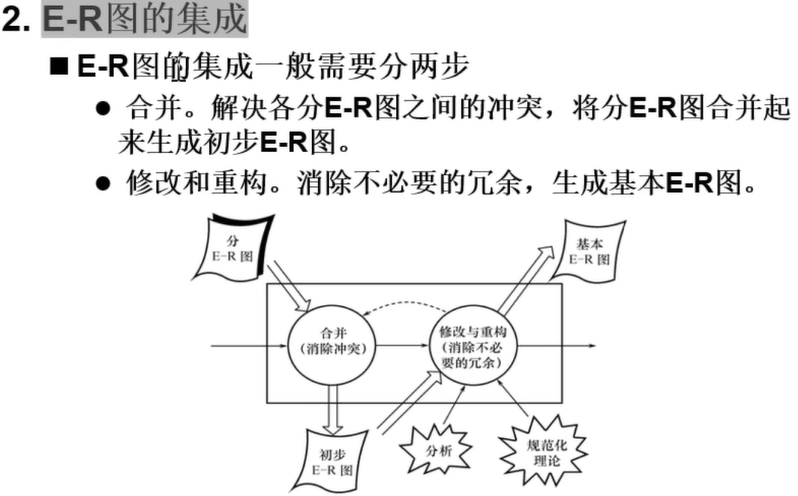
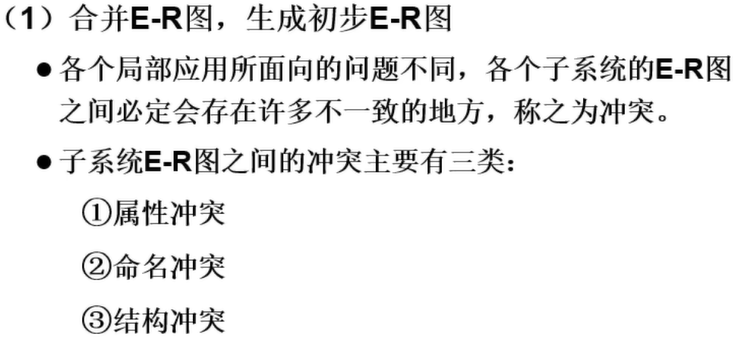
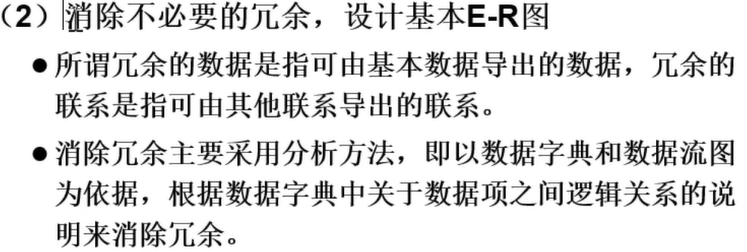
7.4 逻辑结构设计
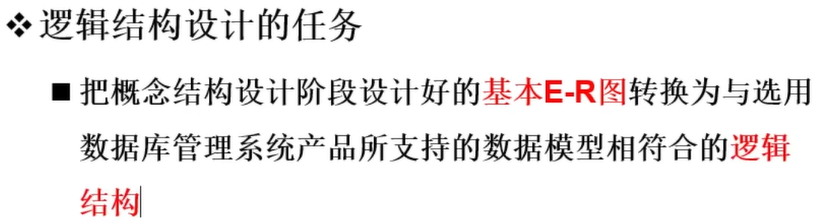
7.4.1 E-R图像关系模型的转换
转换原则:
一个实体型转换为一个关系模式(实体拆表直接拆)
- 关系的属性:实体的属性
- 关系的键:实体的键
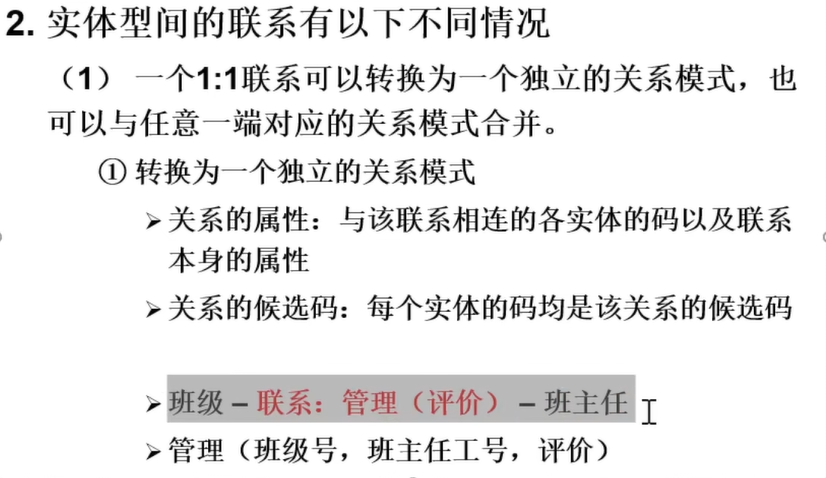
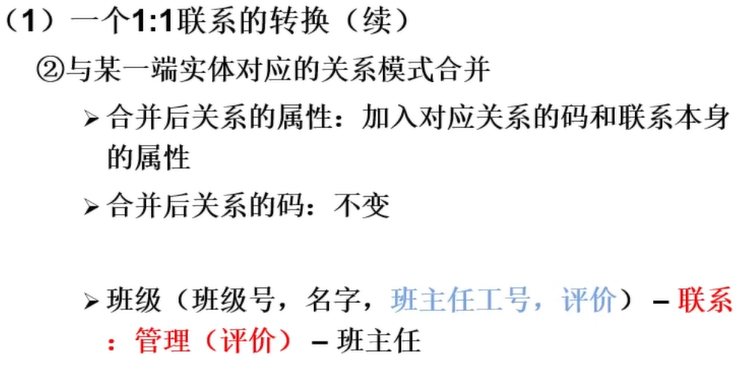
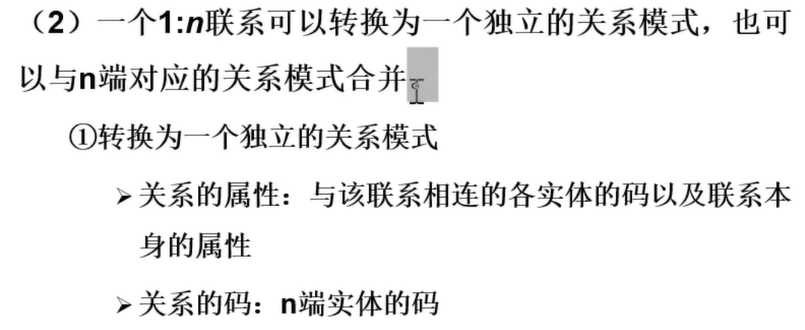
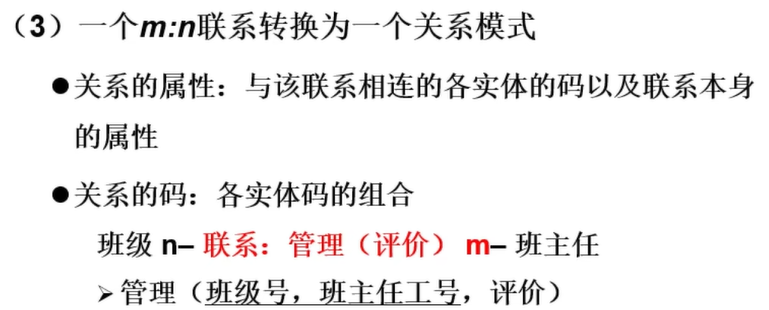
考试过程中可以无脑拆表。 实体单独成表。联系也单独成表,两端主键拿进来就行。
7.4.2 数据模型的优化
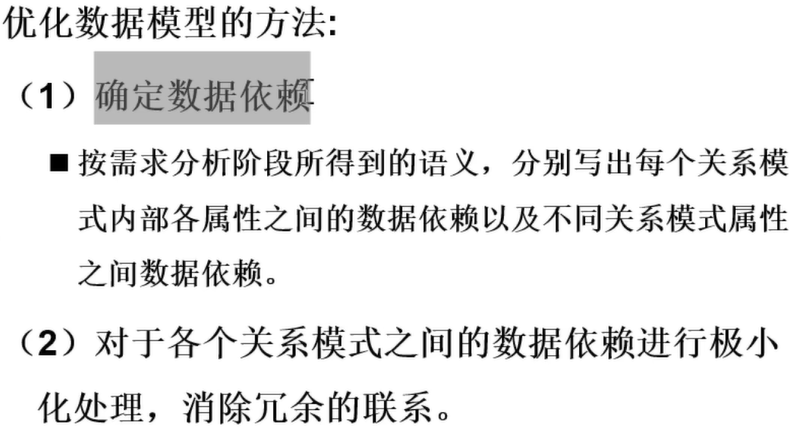
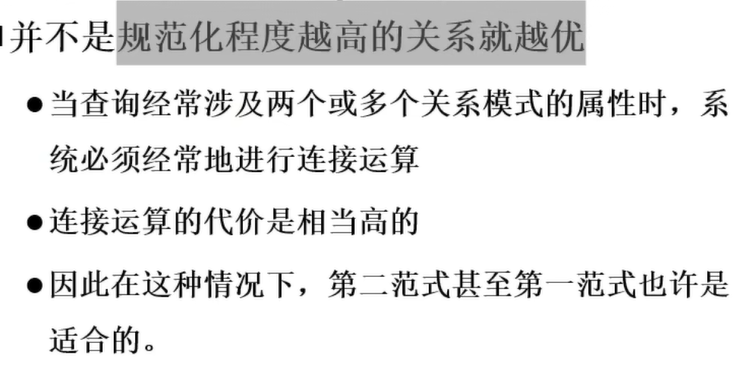
7.5 物理结构设计
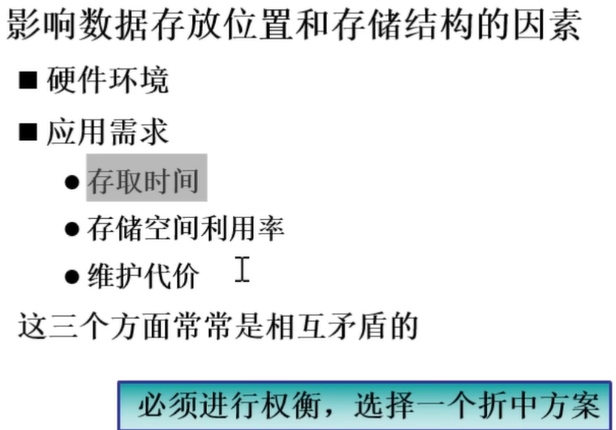
什么是数据库的物理设计:
- 数据库在物理设备上的存储结构与存取方法称为数据库的物理结构,它依赖于选定的数据库管理系统。
- 为一个给定的逻辑数据模型选取一个最适合应用要求的物理结构的过程,就是数据库的物理设计。
数据库物理设计的步骤:
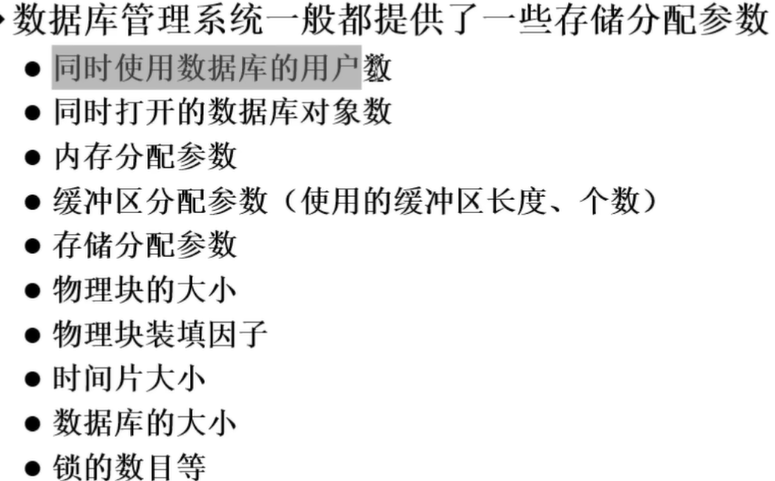
- 确定数据库的物理结构:在关系数据库中主要指存取方法和存储结构
- 对物理结构进行评价:评价的重点是时间和空间效率
- 若评价结果满足原设计要求,则可进入到物理实施阶段。否则,就需要重新设计或修改物理结构,有时甚至要返回逻辑设计阶段修改数据模型。
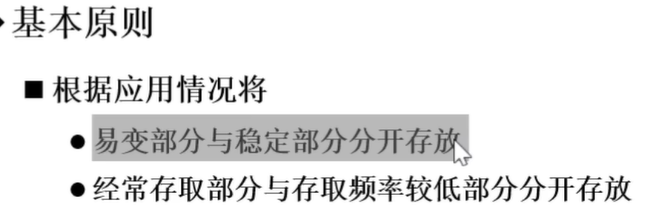
7.5.1 存取方法
数据库管理系统常用存取方法:
- B+树索引存取方法
- Hash索引存取方法
- 聚簇存取方法
B+树选择索引存取方法的主要内容:
- 对哪些属性列建立索引
- 对哪些属性列建立组合索引
- 对哪些索引要设计为唯一索引
关系上定义过多索引会带来较多的额外开销:
- 维护索引的开销
- 查找索引的开销
选择Hash存取方法的规则: 如果一个关系的属性主要出现在等值连接条件中或要出现在等值比较选择条件中,而且满足下列两个之一
- 该关系的大小可预知,而且不变
- 该关系的大小动态改变,但所选用的数据库管理系统提供了动态Hash存取方法。
什么是聚簇: 为了提高某个属性(或属性组)的查询速度,把这或这些属性(称为聚簇码cluster key)上具有相同值的元组集!存放在连续的物理块中称为聚簇。许多关系型数据库管理系统都提供了聚簇功能。
聚簇索引:
- 建立聚簇索引后,基表中数据也需要按指定的聚簇属性值的升序或降序存放。也即聚簇索引的索引项顺序与表中元组的物理顺序一致。
- 在一个基本表上最多只能建立一个聚簇索引
聚簇索引的适用条件:
- 很少对基本表进行增删操作
- 很少对其中的变长列进行修改操作
选择聚簇存取方式:
- 常在一起进行连接操作的关系可以建立组合聚簇
- 如果一个关系的一组属性经常出现在相等比较条件中,则该单个关系可建立聚簇;
- 如果一个关系的一个(或一组)属性上的值重复率很高,则此单个关系可建立聚簇
7.5.2 评价物理结构
7.6 小结
数据库的设计过程:
-
需求分析
-
概念结构设计:画E-R图
-
逻辑结构设计:图转表
物理结构设计:由DBMS决定,我们不关心
-
数据库实施
-
数据库运行维护
设计过程中往往还会有许多反复

八、数据库编程(没学了)
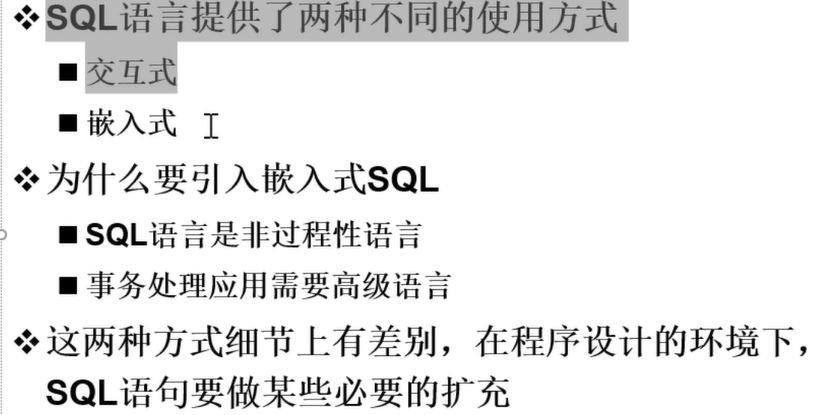
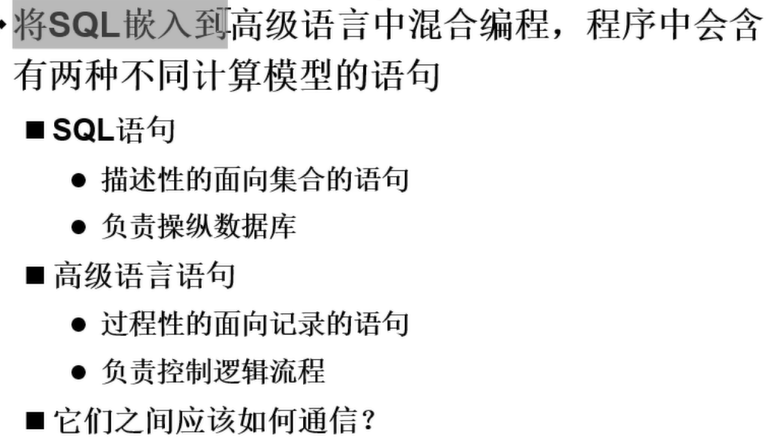
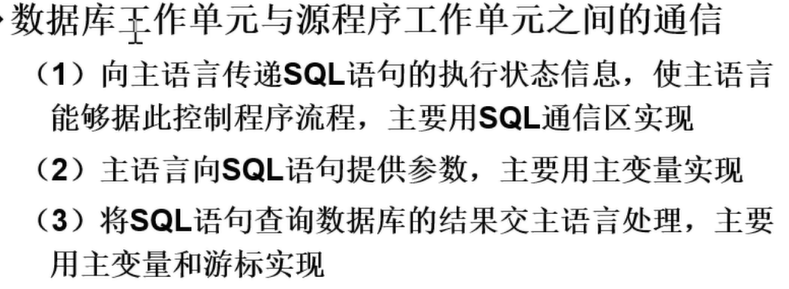
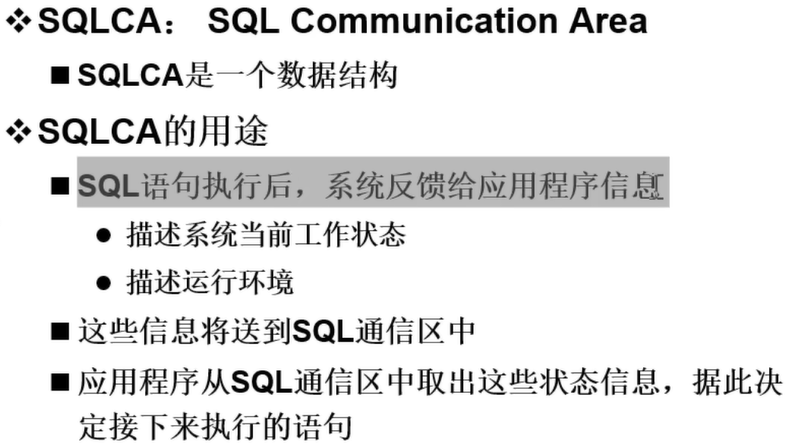
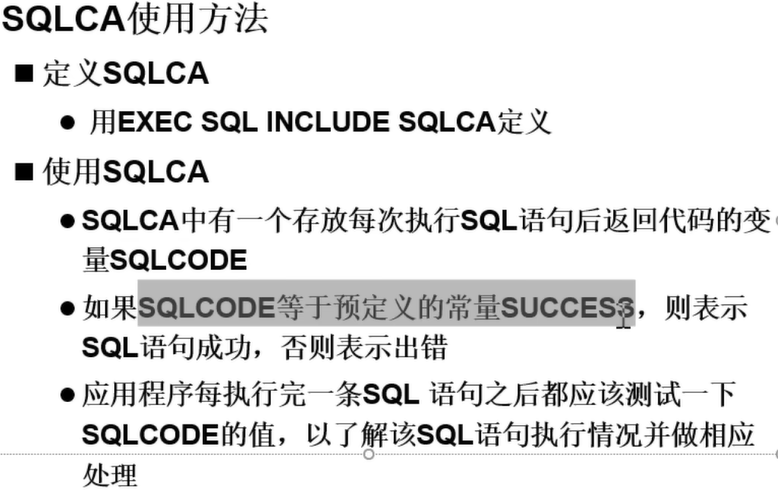
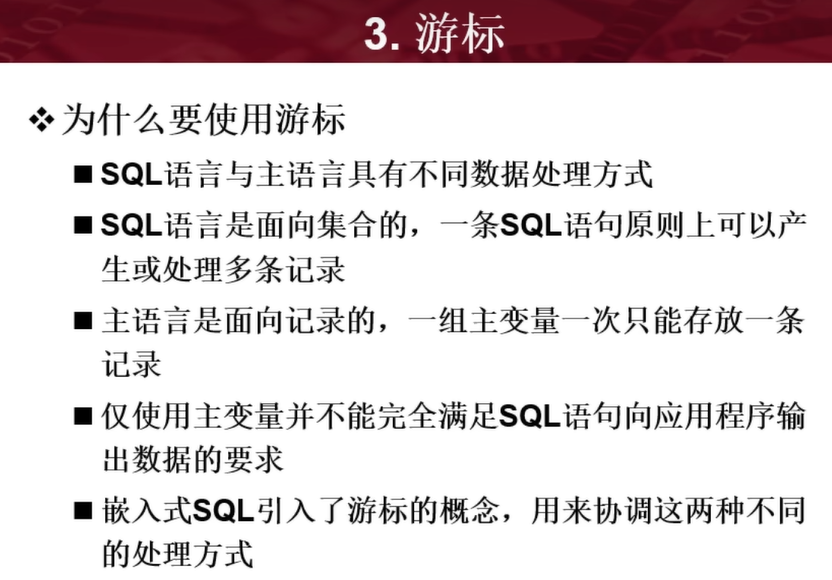
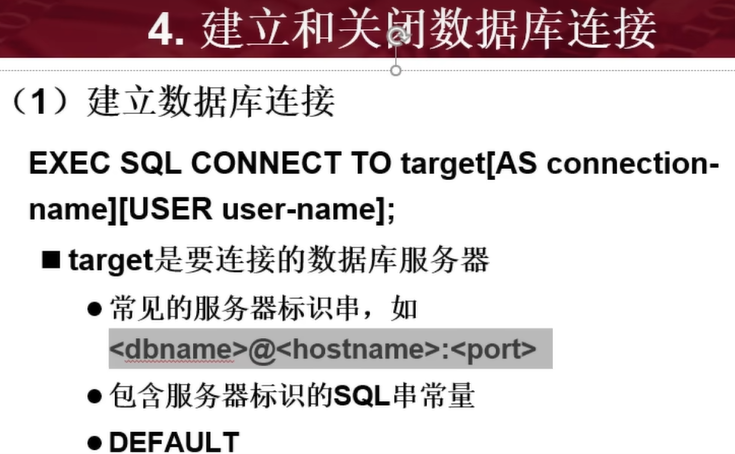
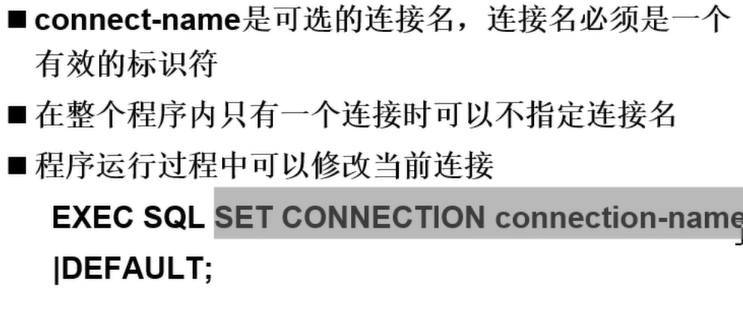
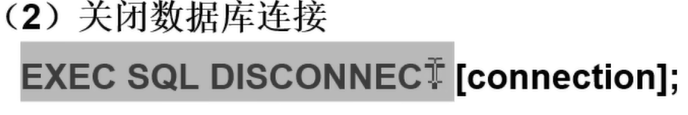
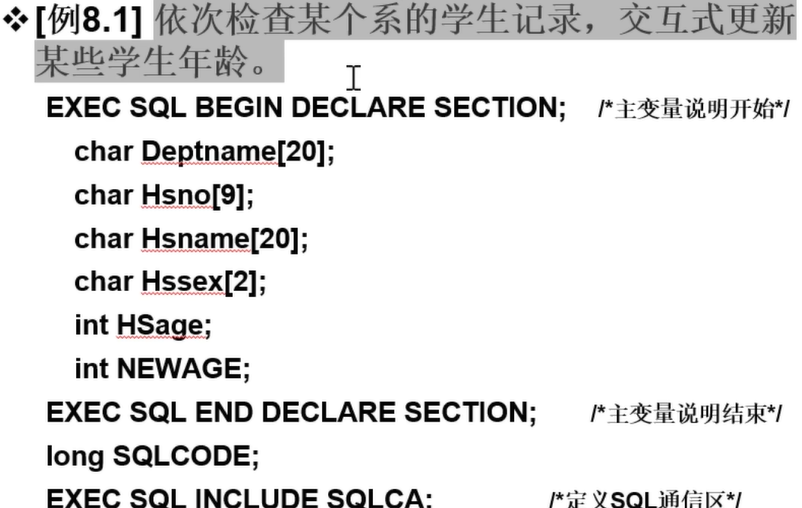
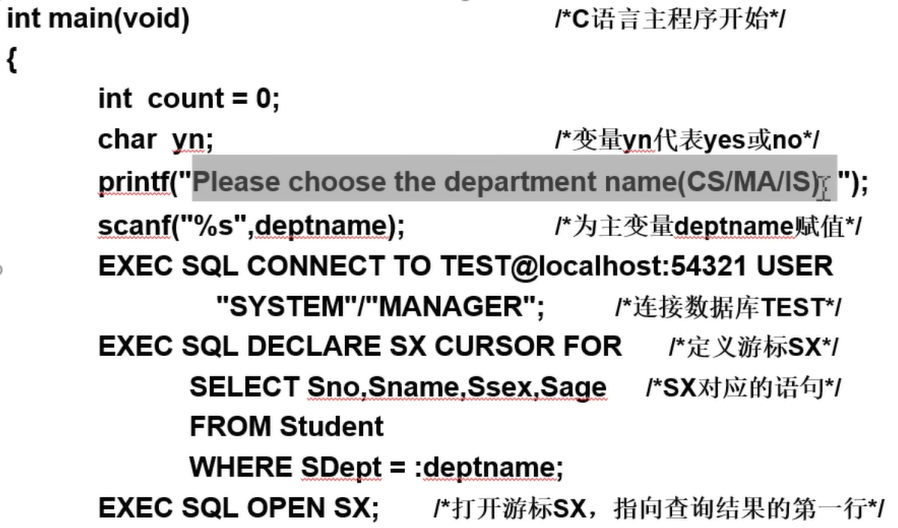
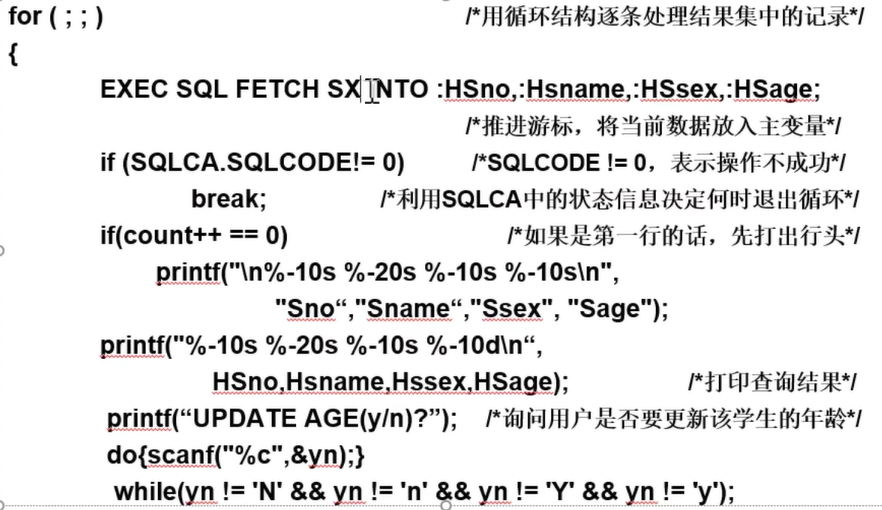
8.1 嵌入式SQL
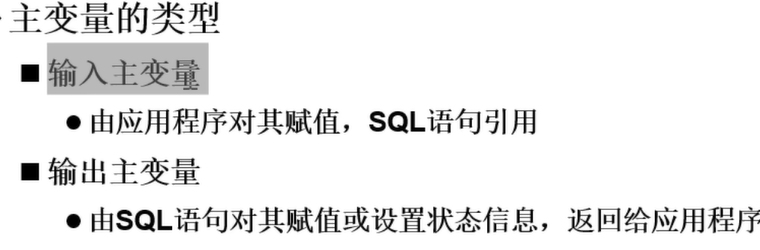
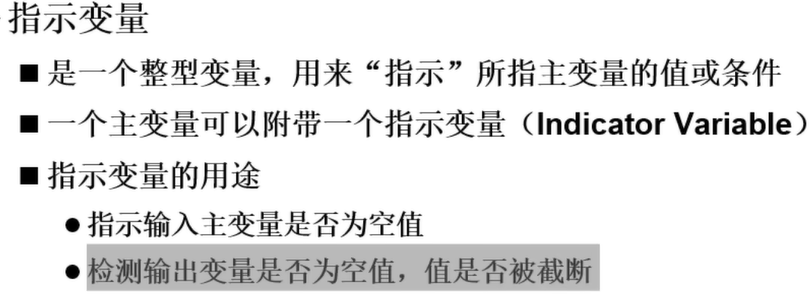
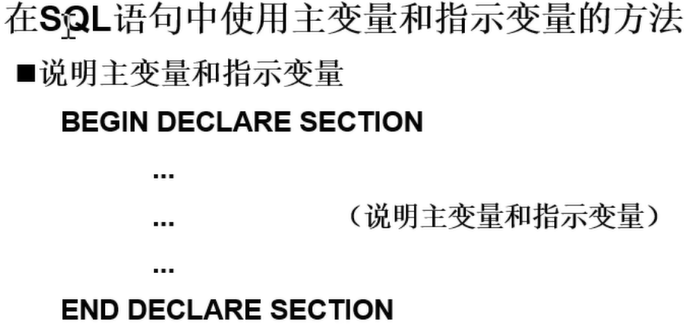
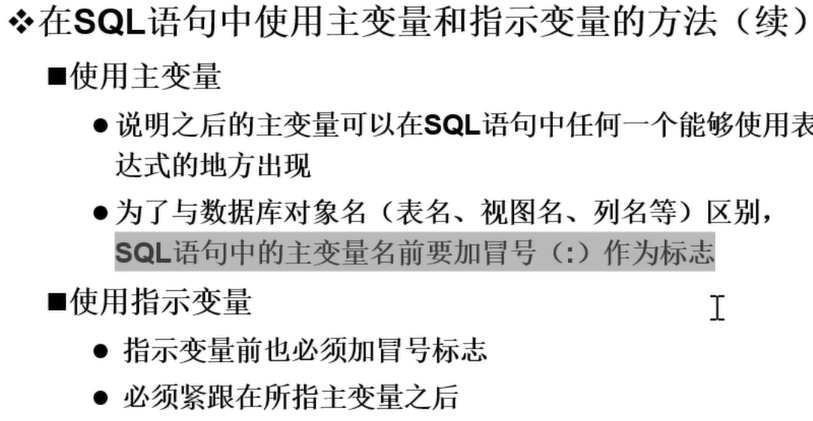

8.2 过程化SQL
8.3 存储过程和函数
8.4 ODBC编程
8.5 OLE DB
8.6 JDBC编程

 浙公网安备 33010602011771号